Diese Technologie wird als Vorschau bereitgestellt und in zukünftigen Versionen weiter verbessert.
Einen Container zur Hypothesenfilterung einrichten
1
Container erstellen
Klicken Sie auf den Block mit der Deep Learning-Aktivität und wählen Sie Filter Hypotheses aus. Dadurch wird ein neuer Container zur Hypothesenfilterung erstellt, in den die ausgewählte Deep Learning-Aktivität eingefügt wird.
2
Weitere Deep Learning-Aktivitäten hinzufügen (optional)
Ziehen Sie weitere Deep Learning-Aktivitäten auf den Container zur Hypothesenfilterung. So können Sie die Ausgabe von zwei oder mehr Deep Learning-Aktivitäten kombinieren und vergleichen. Zwei Aktivitäten können beispielsweise erforderlich sein, wenn Sie gleichzeitig mit Textfeldern und Tabellen arbeiten.
3
Eine Aktivität „Extraktionsregeln“ hinzufügen
Fügen Sie dem Container eine Aktivität „Extraktionsregeln“ hinzu. Sie können entweder durch Klicken auf den Platzhalter eine neue Aktivität erstellen oder eine vorhandene Aktivität auf den Container ziehen.
4
Die Aktivität „Extraktionsregeln“ einrichten
Fügen Sie für jeden von den Deep Learning-Aktivitäten gefundenen Wert ein Deep Learning-Suchelement hinzu und legen Sie dessen Eigenschaften fest. Sie können alle Ausgabefelder einer Deep Learning-Aktivität gleichzeitig hinzufügen. Ein Deep Learning-Suchelement unterstützt alle Eigenschaften, die den Suchbereich und die Bedingungen zum Auffinden des Elements einschränken.
5
Den Container mit dem Workflow verbinden
Verbinden Sie Ein- und Ausgabe des Containers zur Hypothesenfilterung mit anderen Blöcken im Dokumentenverarbeitungs-Workflow. Die Ausgabefelder des Containers zur Hypothesenfilterung sind dieselben wie die Ausgabefelder der Aktivität „Extraktionsregeln“.
Beispiele
Dies sind nur einige Beispiele, die zeigen, wie ein Hypothesis-Filtering-Container verwendet werden kann. Es gibt jedoch viele weitere Situationen, in denen Sie diese Funktion nutzen können, um die Ausgabe neuronaler Netze zu steuern und die Felderextraktion zu verfeinern. Welche Anpassungen für die Dokumente erforderlich sind, mit denen Sie arbeiten, können nur Sie entscheiden. Wir empfehlen, diese Technologie in jedem Fall auszuprobieren, in dem die Ergebnisse der Deep-Learning-Aktivität von einer Feinabstimmung profitieren. Die folgenden Beispiele verwenden dasselbe Beispiel-Skill, bei dem die Ausgaben von zwei Deep-Learning-Aktivitäten an eine Extraction-Rules-Aktivität übergeben werden.Skill-Workflow
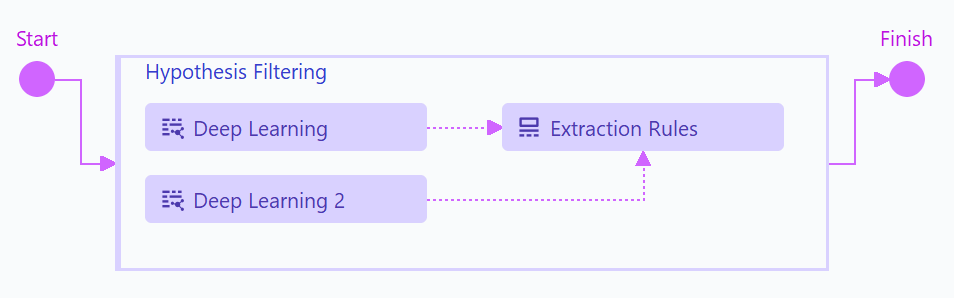
- Die Aktivität „Deep Learning“ extrahiert Textfelder.
- Die Aktivität „Deep Learning 2“ extrahiert eine Tabelle.
- Der Container zur Hypothesenfilterung wählt ihre Ergebnisse aus und kombiniert sie.
Struktur der Suchelemente in der Aktivität „Extraktionsregeln“
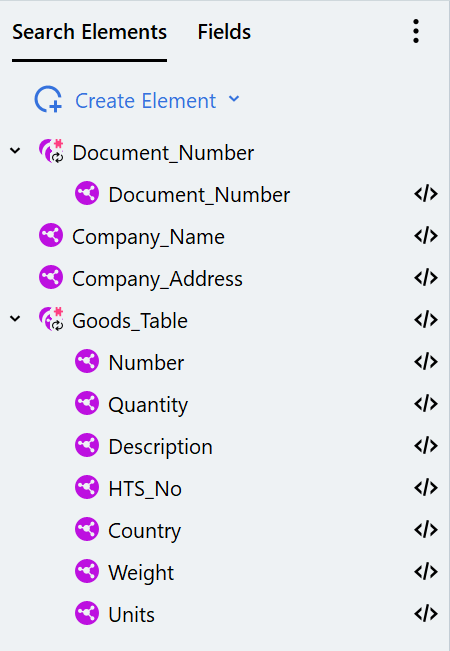
Beispiel 1: Einen von einer Deep-Learning-Aktivität gefundenen Wert korrigieren
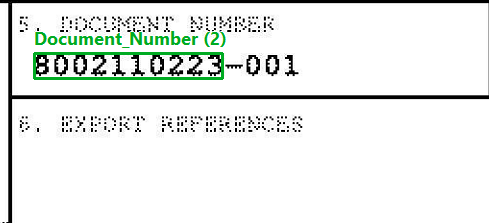
In diesem Beispiel findet eine Deep-Learning-Aktivität einen Wert für die Dokumentnummer, der zu lang ist. Deshalb wird ein neues Suchelement erstellt, um den Wert zu korrigieren. Der von der Deep-Learning-Aktivität gefundene Wert für die Dokumentnummer enthält den Teil nach dem Bindestrich: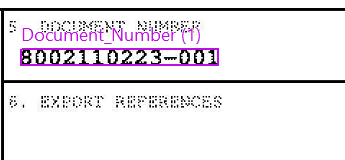
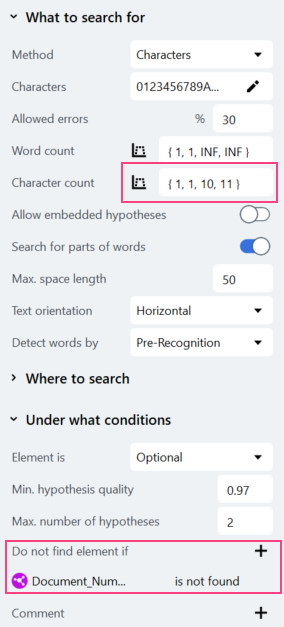
- Um den Wert Document_Number zu korrigieren, wird ein neues Suchelement erstellt. Dieses Suchelement mit dem Namen DocNumber_Corrected sollte sich innerhalb der Region des Suchelements Document_Number befinden und eine begrenzte Anzahl von Zeichen enthalten.
- Der Suchbereich für das neue Element wird eingeschränkt, sodass er der Region von Document_Number entspricht. Dazu wird die folgende Zeile zum Code des Elements hinzugefügt:
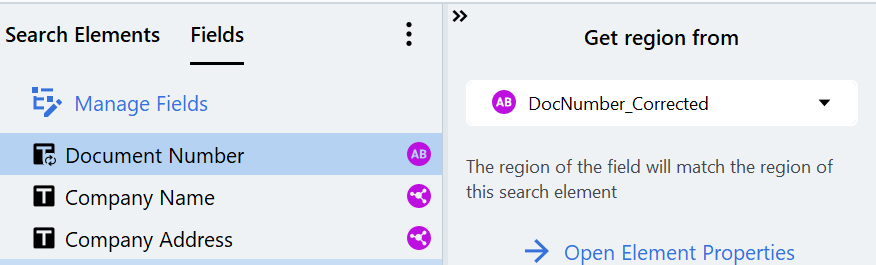
- Das korrigierte Suchelement wird dem Feld zugeordnet, das die Dokumentnummer extrahiert:
Beispiel 2: Einen von mehreren wiederkehrenden Werten auswählen
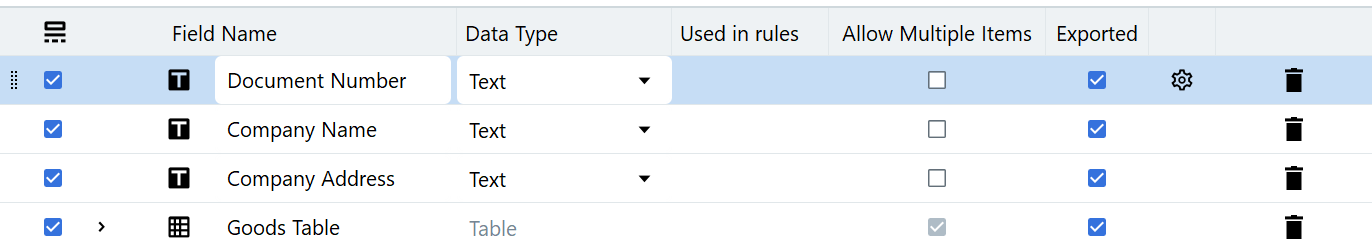
In diesem Beispiel wird eine Deep-Learning-Aktivität darauf trainiert, alle Vorkommen der Dokumentnummer zu finden, das Ergebnis der Skill benötigt jedoch nur ein einziges Dokumentnummern-Feld. Um dies zu erreichen, wird die Einstellung Mehrere Elemente zulassen für das Feld Dokumentnummer deaktiviert und es werden Bedingungen festgelegt, um das richtige Vorkommen der Dokumentnummer auszuwählen. Wir empfehlen, zunächst den gelabelten Dokumentensatz in einem Ordner zu speichern. Wenn Sie die Einstellung Mehrere Elemente zulassen für ein Feld deaktivieren, werden alle zusätzlichen Vorkommen dieses Felds aus der Labeling-Ansicht entfernt. Das in der Deep-Learning-Aktivität trainierte Modell funktioniert weiterhin; möchten Sie es jedoch ändern und neu trainieren, müssen Sie den ursprünglichen Dokumentensatz laden.- Die Einstellung Mehrere Elemente zulassen ist für das Feld Dokumentnummer deaktiviert (die Einstellung kann über Manage Fields aufgerufen werden).
- Das Suchelement Document_Number mit mehreren Vorkommen kann dem Feld Dokumentnummer nicht zugeordnet werden. Daher wird ein neues Deep Learning-Suchelement aus der Ausgabe der Dokumentnummer der Deep-Learning-Aktivität erstellt und dem Feld Dokumentnummer zugeordnet.
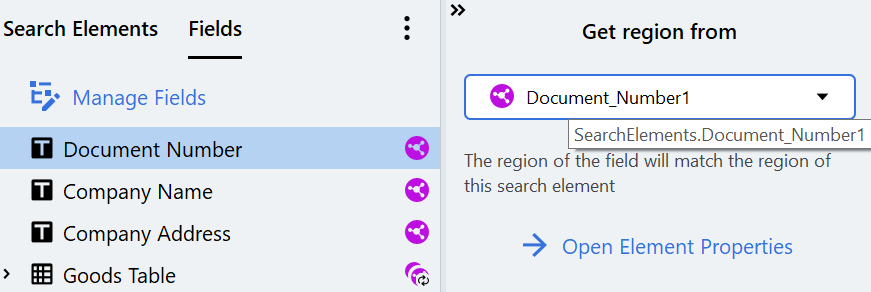
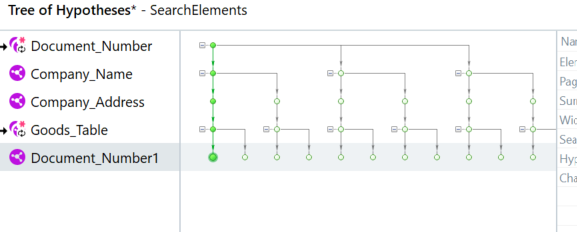
- Die mehreren Vorkommen der Dokumentnummer, die von der Deep-Learning-Aktivität gefunden wurden, werden verwendet, um einen Hypothesenbaum zu erstellen, von dem nur eines als Wert des Suchelements Document_Number ausgewählt wird.
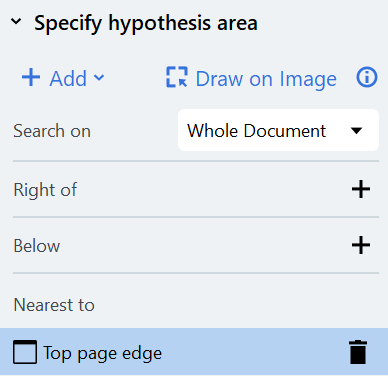
- Um ein bestimmtes Vorkommen zu finden, werden für das Suchelement Document_Number bestimmte Bedingungen hinzugefügt (in diesem Fall möchten wir das oberste Vorkommen der Dokumentnummer finden).
Beispiel 3: Ausgabe von zwei Deep-Learning-Aktivitäten kombinieren
Ein Container zur Hypothesenfilterung ermöglicht es, die Ergebnisse von zwei oder mehr Deep-Learning-Aktivitäten zu kombinieren, um sie miteinander abzugleichen oder diese Ergebnisse innerhalb derselben Aktivität weiter zu verfeinern. In diesem Beispiel waren zwei Deep-Learning-Aktivitäten erforderlich, da eine einzelne Deep-Learning-Aktivität nicht dafür trainiert werden kann, sowohl Textfelder als auch Tabellen zu extrahieren. Es wird eine Bedingung hinzugefügt, die festlegt, dass das Suchelement Company_Address stets oberhalb des Suchelements Goods_Table gefunden werden soll. Dadurch wird die richtige Adresse erkannt, selbst wenn andere Adressen am unteren Rand der Seite gedruckt sind.