このテクノロジーはプレビューとして提供されており、今後のバージョンで改善される予定です。
仮説フィルタリングコンテナーを設定する
1
コンテナーを作成する
Deep Learning アクティビティがあるブロックをクリックし、Filter Hypotheses を選択します。すると、新しい 仮説フィルタリングコンテナーが作成され、選択した Deep Learning アクティビティがその中に配置されます。
2
Deep Learning アクティビティをさらに追加する(任意)
さらに Deep Learning アクティビティを 仮説フィルタリングコンテナーにドラッグします。これにより、2 つ以上の Deep Learning アクティビティの出力を組み合わせて比較できるようになります。たとえば、テキストの field とテーブルを同時に扱う場合は、2 つのアクティビティが必要になることがあります。
3
Extraction Rules アクティビティを追加する
コンテナーに Extraction Rules アクティビティを追加します。placeholder をクリックして新しいアクティビティを作成することも、既存のアクティビティをコンテナーにドラッグすることもできます。
4
Extraction Rules アクティビティを設定する
Deep Learning アクティビティで見つかった各値について、Deep Learning 検索要素 を追加し、そのプロパティを設定します。1 つの Deep Learning アクティビティのすべての output field を一度に追加できます。Deep Learning 検索要素 は、検索範囲を制限するすべてのプロパティと、element を見つける条件をサポートしています。
5
コンテナーをワークフローに接続する
仮説フィルタリングコンテナーの入力と出力を、文書処理ワークフロー内の他のブロックに接続します。仮説フィルタリングコンテナーの output field は、Extraction Rules アクティビティの output field と同じになります。
例
Skill ワークフロー
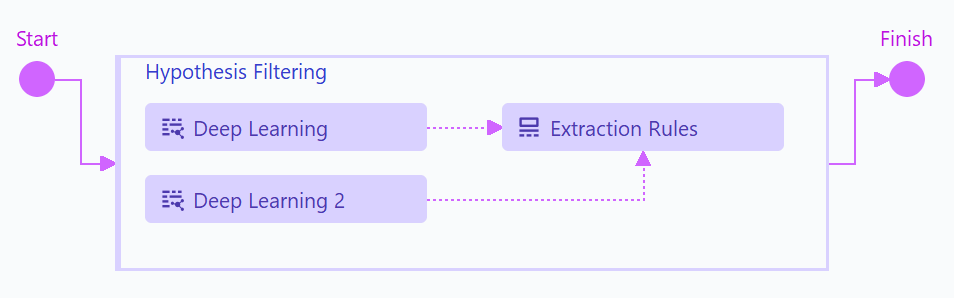
- Deep Learning アクティビティでテキストの field を抽出します。
- Deep Learning 2 アクティビティでテーブルを抽出します。
- 仮説フィルタリングコンテナーでそれらの結果を選択・統合します。
Extraction Rules アクティビティにおける検索要素の構造
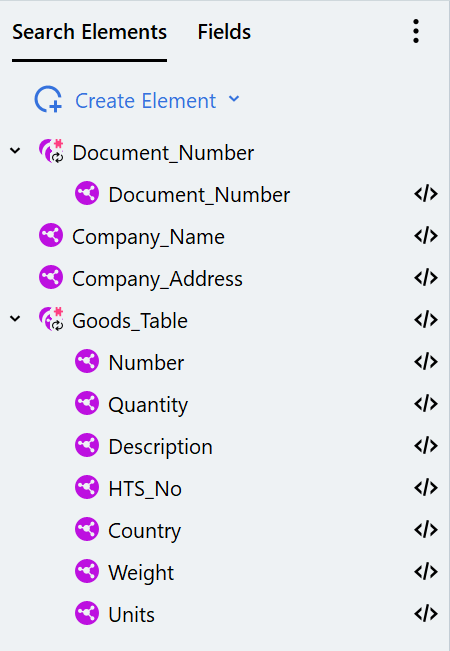
例 1: Deep Learning アクティビティで見つかった値を修正する
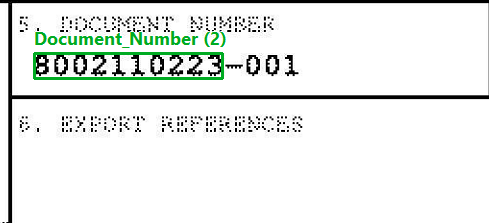
この例では、Deep Learning アクティビティが長すぎる文書番号の値を検出し、その値を修正するために新しい検索要素を作成します。 Deep Learning アクティビティで見つかった文書番号の値には、ダッシュ以降の部分が含まれています。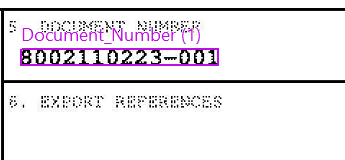
- Document_Number の値を修正するために、新しい検索要素を作成します。DocNumber_Corrected という名前のこの検索要素は、Document_Number 検索要素の領域内に配置し、文字数を制限する必要があります。
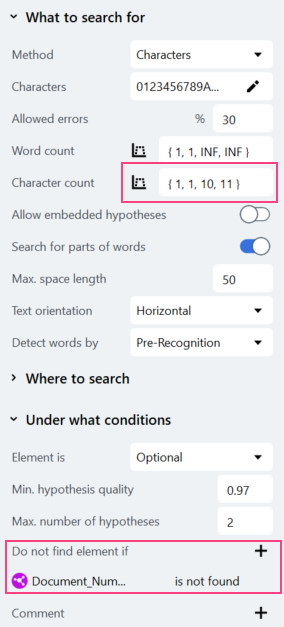
- 新しい要素の検索領域は、要素のコードに次の行を追加して、Document_Number の領域に一致するように制限します。
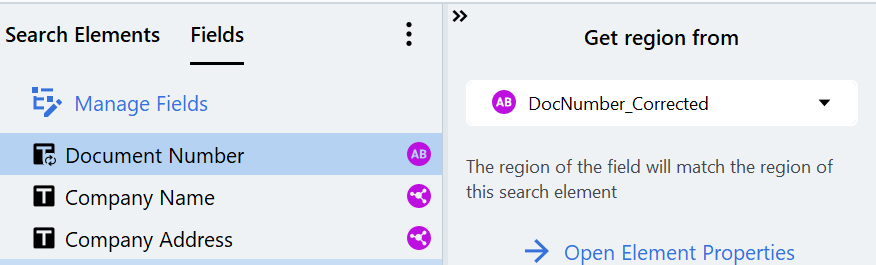
- 修正した検索要素は、文書番号を抽出するfieldにマッピングされます。
例 2: 複数回検出された値から 1 つを選択する
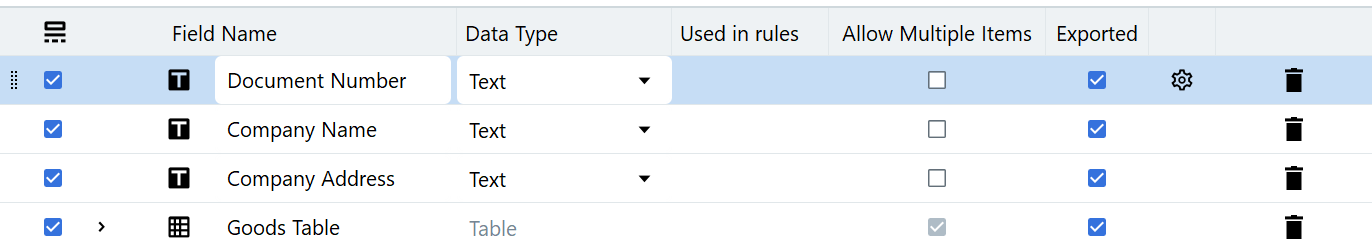
この例では、Deep Learning アクティビティは文書番号のすべての出現箇所を検出するように学習されていますが、Skill の最終結果としては文書番号の field は 1 つだけで十分です。これを実現するため、文書番号 field の Allow Multiple Items 設定を無効にし、文書番号の正しい出現箇所を選択する条件を設定します。 まず ラベル付け済みドキュメント セットを保存 してフォルダーに置くことを推奨します。ある field で Allow Multiple Items 設定を無効にすると、その field の余分な出現箇所はラベリングからすべて削除されます。Deep Learning アクティビティで学習されたモデルは引き続き機能しますが、変更して再学習する場合は元のドキュメント セットを読み込む必要があります。- 文書番号 field で Allow Multiple Items 設定を無効にします (この設定は Manage Fields をクリックして開きます) 。
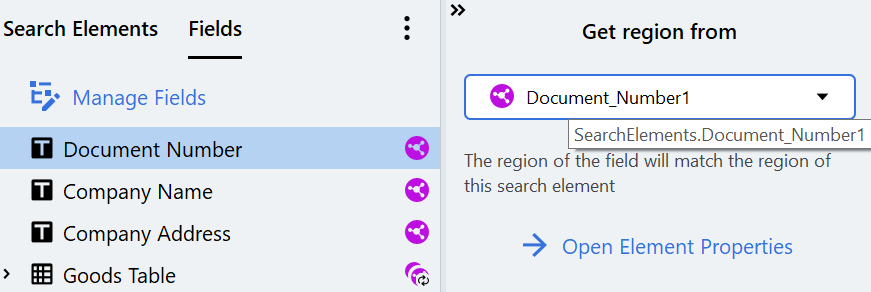
- 複数の出現箇所を持つ Document_Number 検索要素は 文書番号 field にマッピングできません。そのため、Deep Learning アクティビティの文書番号の出力から新しい Deep Learning 検索要素を作成し、文書番号 field にマッピングします。
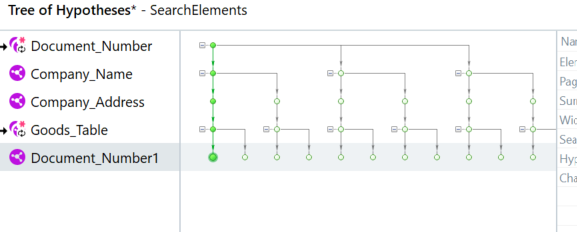
- Deep Learning アクティビティで見つかった文書番号の複数の出現箇所をもとに仮説ツリーを構築し、そのうち 1 つだけを Document_Number 検索要素の値として選択します。
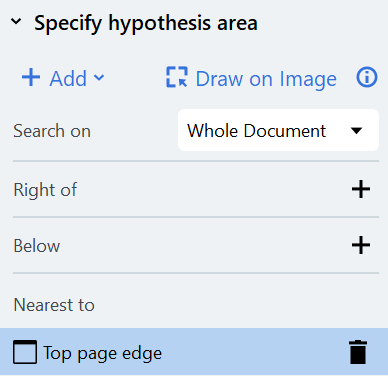
- 特定の出現箇所を見つけるため、Document_Number 検索要素に条件を追加します (この例では、文書番号の最上段の出現箇所を選択します) 。
例 3: 2 つの Deep Learning アクティビティの出力を組み合わせる
仮説フィルタリングコンテナーを使用すると、2 つ以上の Deep Learning アクティビティの結果を組み合わせ、相互に照合したり、同一アクティビティ内で結果を微調整したりできます。 この例では、テキストの field と表の両方を抽出するように 1 つの Deep Learning アクティビティを学習させることはできないため、2 つの Deep Learning アクティビティが必要でした。 条件として、Company_Address 検索要素は常に Goods_Table 検索要素の上に見つかるよう指定します。これにより、ページ下部に他の住所が印字されている場合でも、正しい住所が検出されます。