
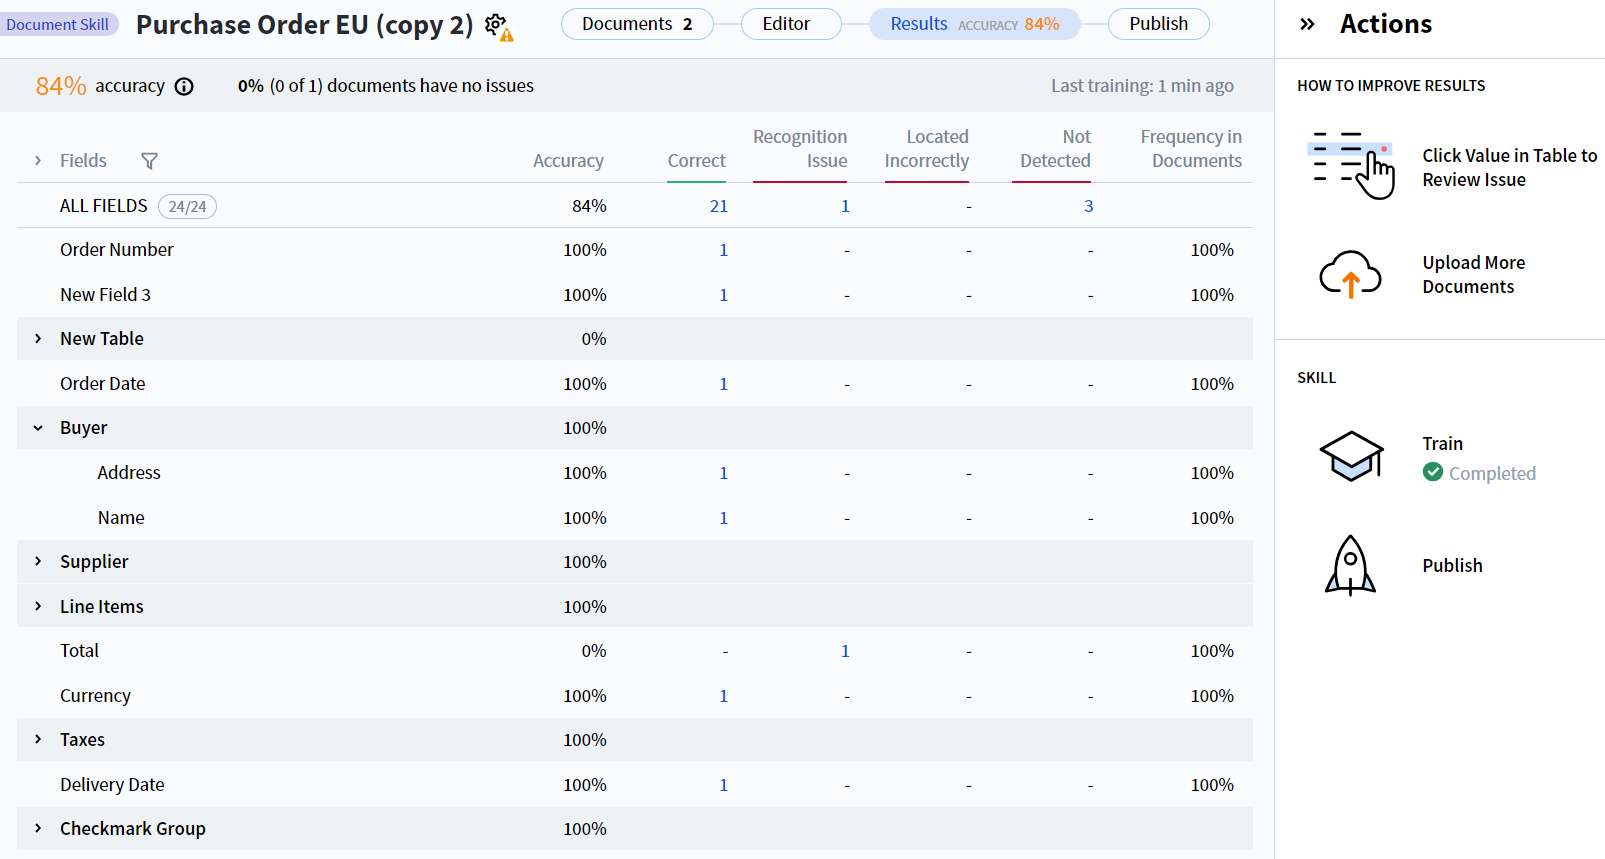
Statistiques d’extraction des champs dans l’onglet Results
-
Accuracy — Pourcentage de champs dont les valeurs ont été correctement extraites, à la fois pour chaque champ et pour l’ensemble des champs (ligne ALL FIELDS).
La précision par champ est calculée comme suit :
La ligne ALL FIELDS utilise la même formule, chaque terme étant agrégé sur l’ensemble des champs.
- Correct — Nombre d’instances de champ dont la valeur extraite correspond à la valeur de référence.
- problème de reconnaissance — Nombre d’instances de champ détectées dans le document, mais non correctement reconnues.
- mauvaise localisation — Nombre d’instances de champ dont les valeurs diffèrent des valeurs prédites, car leurs régions ont été détectées à des emplacements différents de ceux définis dans l’annotation.
- non détecté — Nombre d’instances de champ non détectées.
- Frequency in Documents — Pourcentage de documents contenant le champ donné.
Pour que ces statistiques reflètent la qualité en production, la distribution des documents de votre jeu de test doit correspondre à celle observée en production. Par exemple, si 30 % de vos factures en production proviennent d’un fournisseur particulier, environ 30 % du jeu de test doivent également en provenir. L’utilisation d’un jeu aveugle (documents non utilisés pour l’entraînement ni lors de tests précédents) renforce encore la validité des résultats.
Examiner les champs extraits avec des erreurs
Pour afficher les documents qui contiennent des champs extraits avec des erreurs, cliquez sur la valeur dans la colonne Problème de reconnaissance, Mauvaise localisation ou Non détecté du champ que vous examinez.En cliquant sur la valeur dans la colonne Problème de reconnaissance pour le champ Order Date, un onglet s’ouvre affichant uniquement les documents dans lesquels Order Date présente un problème de reconnaissance.
Modes d’extraction
L’onglet Result Review vous permet d’examiner les résultats d’extraction, les erreurs d’étiquetage et les problèmes de reconnaissance, et de comparer l’étiquetage effectué lors de la configuration avec le résultat obtenu après l’entraînement. Les documents peuvent être affichés dans trois modes :- Reference — Affiche l’étiquetage de référence créé lors de la configuration de la compétence (avant l’entraînement), ainsi que les valeurs de champ extraites à partir de celui-ci. Les valeurs de champ et les régions peuvent être modifiées dans ce mode.
- Predicted — Affiche les valeurs de champ et les régions obtenues lors du traitement des documents. Non modifiable.
- Difference — Affiche les différences entre l’étiquetage de référence et l’étiquetage prédit. Les valeurs et les régions identiques apparaissent en vert ; celles qui diffèrent apparaissent en rouge. Non modifiable.
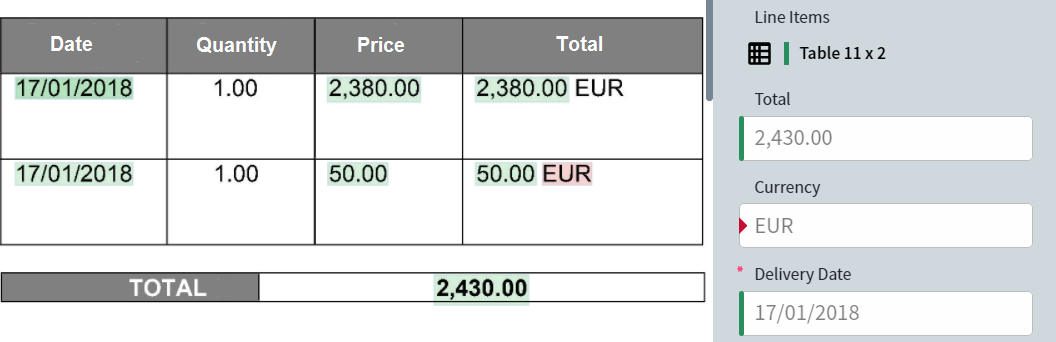
Le mode Difference met en évidence les écarts en rouge
Corriger l’étiquetage de référence
Si un champ a été étiqueté incorrectement pendant la configuration, mais traité correctement lors de l’entraînement, vous pouvez mettre à jour l’étiquetage de référence. Passez en mode Difference et cliquez sur l’icône au-dessus de la valeur du champ mal étiqueté :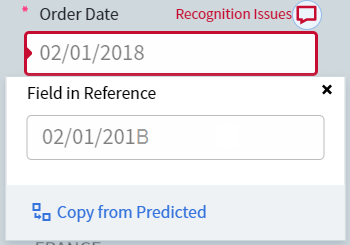
Indicateur de problèmes de reconnaissance sur un champ étiqueté