- Un même ensemble qui contient à la fois des documents semi-structurés et non structurés (différents types de documents).
- Un seul document qui présente une structure mixte — par exemple, un contrat non structuré avec des tableaux intégrés, des titres, des en-têtes ou des pieds de page.
Choisissez un scénario
Chaque scénario ci-dessous suit une structure commune ; seules les activités que vous ajoutez au flux de traitement diffèrent.
Workflow type
1
Créer une compétence de document
Ouvrez Advanced Designer et cliquez sur Créer une compétence de document dans la page d’accueil.
2
Téléverser des documents
Dans l’onglet Documents, téléversez les documents que vous utiliserez pour configurer la compétence.
3
Définir les champs et étiqueter les documents
Dans l’onglet Fields, créez et configurez les champs que la compétence extraira. Étiquetez les documents dans la section Reference.
4
Ajouter et configurer des activités
Dans l’onglet Activities, ajoutez les activités adaptées à votre scénario (décrit ci-dessous). Ouvrez chaque activité dans l’Éditeur d’activité pour la configurer et l’entraîner.
5
Tester et publier
Cliquez sur Test Skill Using Selected Documents pour évaluer les résultats. Lorsque ceux-ci sont suffisamment bons, publier la compétence.
Documents semi-structurés et non structurés dans un même ensemble
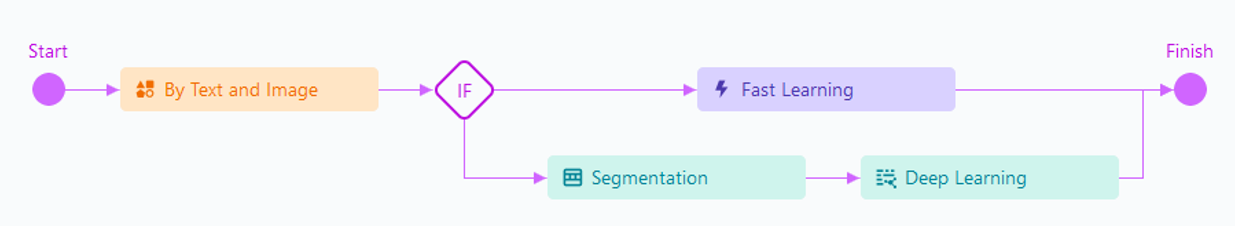
Utilisez ce scénario lorsqu’une Compétence de document doit traiter à la fois des documents semi-structurés et non structurés — ils appartiennent au même type logique et partagent le même ensemble de champs de sortie. Classez chaque document avec une activité Classify By Text and Image, qui combine le texte et la géométrie pour prendre en charge les images de mauvaise qualité et les documents qui ne se distinguent que par des éléments graphiques (signatures, sceaux). Pour obtenir les meilleurs résultats, téléversez un nombre à peu près équivalent de documents pour chaque variante, afin que le classificateur dispose de données d’entraînement équilibrées. Ensuite, créez un branchement dans le flux à l’aide d’une activité IF :- Traitez les documents semi-structurés avec une activité Fast Learning.
- Traitez les documents non structurés avec une activité Segmentation, suivie d’une activité Deep Learning for NLP.
Cellules de tableau avec des champs intégrés au texte de la cellule
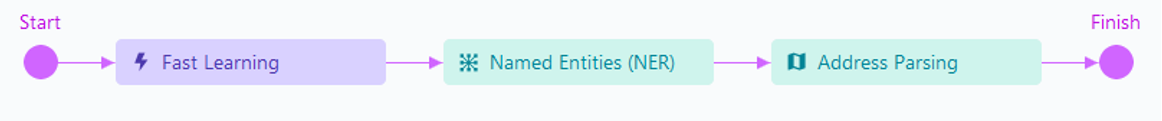
Utilisez ce scénario lorsque vous devez extraire des valeurs spécifiques à l’intérieur de cellules de tableau dans des documents semi-structurés — par exemple, le nom d’un emprunteur et une partie de son adresse intégrés dans une cellule de Closing Disclosure. Extrayez la cellule comme un bloc de texte unique avec une activité Fast Learning, puis exécutez des activités NLP sur ce bloc pour en extraire les champs intégrés :- activité Named Entities (NER) pour les entités telles que les noms et les organisations.
- activité Address Parsing pour décomposer les adresses en éléments.
Documents non structurés avec des tableaux, des titres, des en-têtes ou des pieds de page
Utilisez ce scénario pour des documents essentiellement non structurés (par exemple, des contrats) qui contiennent toutefois des fragments semi-structurés imbriqués, comme des tableaux, des titres, des en-têtes ou des pieds de page. Détectez les paragraphes de texte brut avec une activité Segmentation et les fragments semi-structurés avec une activité Extraction Rules. Une fois chaque fragment isolé, utilisez l’activité appropriée pour en extraire les champs.