- activité Segmentation
- activité Deep Learning for NLP
- activité Named Entities (NER)
- activité Address Parsing
Chacune de ces activités prend en charge un nombre limité de langues. Consultez la page de référence de l’activité pour voir la liste des langues.
Choisissez un scénario
Chaque scénario ci-dessous suit un schéma commun ; seules les activités ajoutées au flux de traitement diffèrent.
Workflow type
1
Créer une compétence de document
Ouvrez Advanced Designer et cliquez sur Create Document Skill sur la page d’accueil.
2
Téléverser des documents
Dans l’onglet Documents, téléversez les documents que vous utiliserez pour configurer la compétence.
3
Définir les champs et annoter
Dans l’onglet Fields, créez et configurez les champs que la compétence extraira. Annotez les documents dans la section Reference.
4
Ajouter et configurer les activités NLP
Dans l’onglet Activities, ajoutez les activités correspondant à votre scénario (décrit ci-dessous). Ouvrez chaque activité dans l’Éditeur d’activité pour la configurer et l’entraîner.
5
Tester et publier
Cliquez sur Test Skill Using Selected Documents pour évaluer les résultats. Lorsque les résultats sont satisfaisants, publiez la compétence.
Entités nommées pré-entraînées (document entier)
Utilisez ce scénario lorsque les entités dont vous avez besoin peuvent apparaître n’importe où dans le document — par exemple, des noms d’entreprise et des adresses dans une lettre. Ajoutez une activité Named Entities (NER) et associez chaque entité nommée à un champ. Si vous devez également décomposer une adresse en composants (rue, ville, état, pays, code postal), ajoutez une activité Address Parsing et associez les composants à des champs.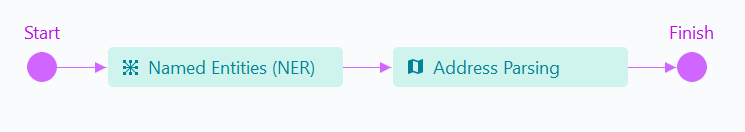
Entités nommées pré-entraînées (paragraphes spécifiques)
Utilisez ce scénario lorsque l’entité se trouve toujours dans le même paragraphe — par exemple, un montant d’achat dans la clause de prix d’un contrat de vente. Isolez d’abord le paragraphe à l’aide d’une activité Segmentation, puis exécutez une activité Named Entities (NER) ou Address Parsing sur le champ segmenté. Vous pouvez également isoler le paragraphe à l’aide d’une activité Fast Learning ou NLP Extraction Rules au lieu de Segmentation, puis exécuter NER ou Address Parsing sur le résultat.
Entités nommées personnalisées (Deep Learning for NLP)
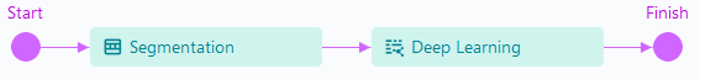
Utilisez ce scénario lorsque les activités pré-entraînées ne parviennent pas à distinguer les entités dont vous avez besoin — par exemple, pour extraire le nom d’une seule organisation à partir d’un paragraphe qui mentionne les deux parties à un accord, ou pour extraire un type d’entité que le NER ne couvre pas (comme une adresse e-mail). Associez une activité Segmentation à une activité Deep Learning for NLP : Segmentation isole le paragraphe et Deep Learning extrait les champs ciblés.L’entraînement d’une activité Deep Learning for NLP nécessite au moins 50 documents (150 recommandés). Pour obtenir les meilleurs résultats, essayez également l’activité pré-entraînée Named Entities (NER) et retenez celle qui offre la meilleure précision sur vos documents.