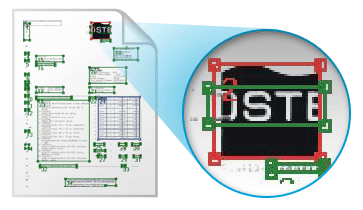
基本的な文書解析機能
文書解析 は、ページ上の次のオブジェクトを自動検出するための一連の機能です。- テキストブロック
- 画像
- テーブルとテーブルセル
- バーコード
- 区切り線
- ページの向き (90 度、180 度、270 度) を検出する
- 見開きページを分割する
- テーブルセル内の縦書きテキストを検出する
- ページ上の不要なブロックを検出してマークする
一般文書解析
これは既定の文書解析タイプで、テキストブロック、画像、表、バーコード、区切り要素など、すべてのオブジェクトを検出します。この解析の結果は、コンテンツ再利用シナリオで文書構造およびレイアウトを取得するために使用されます。すべての画像と図は、内部のテキストを認識せず、元の形のまま保持されます。請求書向けの文書解析
これは、請求書、支払依頼書、請求書類、送り状、名刺、契約書、医療保険請求書、履歴書などの半構造化文書を変換するための前処理エンジンです。これらの文書内にあるすべてのテキストを、文字や数字も含めて正確に特定できるよう設計されており、その情報がスタンプ、画像、ロゴ、または小さな文字領域内にある場合でも対応できます。 標準的なページ全体の文書解析とは異なり、このエンジンでは、文書上の印字情報はすべてテキストであることを前提としています。また、重要なテキスト情報が図形要素として識別されたり、単語や数値が個々の文字に分割されたりしないようにします。その結果、座標を含むテキストに関する可能な限り多くの情報を利用できるようになり、後続の処理段階で他のシステムによる解析、field単位の処理、パースに活用できます。全文索引用の文書解析
画像、グラフ、図表に埋め込まれたテキストを含め、文書内のあらゆるテキストを自動的に検出・認識します。開発者は、この文書解析モードを使用して、文書インデックスの構築 (DMS、CMS、アーカイブシステムなど) に必要な、文書内の全文情報を網羅的に抽出できます。