- Ein einzelner Satz, der sowohl semi-strukturierte als auch unstrukturierte Dokumente enthält (verschiedene Dokumenttypen).
- Ein einzelnes Dokument mit gemischter Struktur — zum Beispiel ein unstrukturierter Vertrag mit eingebetteten Tabellen, Titeln, Kopf- oder Fußzeilen.
Wählen Sie ein Szenario aus
Jedes der folgenden Szenarien folgt einem gemeinsamen Muster; nur die Aktivitäten, die Sie zum Verarbeitungsablauf hinzufügen, unterscheiden sich.
Typischer Workflow
1
Document-Skill erstellen
Öffnen Sie Advanced Designer und klicken Sie auf der Startseite auf Create Document Skill.
2
Dokumente hochladen
Laden Sie auf der Registerkarte Documents die Dokumente hoch, die Sie zum Einrichten des Skills verwenden möchten.
3
Felder definieren und labeln
Erstellen und konfigurieren Sie auf der Registerkarte Fields die Felder, die der Skill extrahieren soll. Labeln Sie die Dokumente im Abschnitt Reference.
4
Aktivitäten hinzufügen und konfigurieren
Fügen Sie auf der Registerkarte Activities die Aktivitäten für Ihr Szenario hinzu (wie unten beschrieben). Öffnen Sie jede Aktivität im Activity Editor, um sie zu konfigurieren und zu trainieren.
5
Testen und veröffentlichen
Klicken Sie auf Test Skill Using Selected Documents, um die Ergebnisse auszuwerten. Wenn die Ergebnisse gut genug sind, veröffentlichen Sie den Skill.
Semi-strukturierte und unstrukturierte Dokumente in einem Set
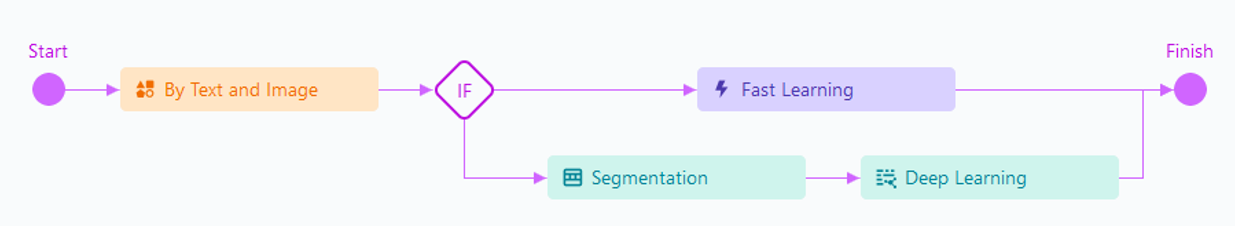
Verwenden Sie dieses Szenario, wenn ein Document-Skill sowohl semi-strukturierte als auch unstrukturierte Dokumente verarbeiten muss — beide gehören zum selben logischen Typ und haben dieselben Ausgabefelder. Klassifizieren Sie jedes Dokument mit einer Classify By Text and Image activity, die Text und Geometrie kombiniert, um Bilder schlechter Qualität und Dokumente zu verarbeiten, die sich nur durch grafische Merkmale (Unterschriften, Siegel) unterscheiden. Um optimale Ergebnisse zu erzielen, laden Sie für jede Variante ungefähr gleich viele Dokumente hoch, damit der Klassifikator mit ausgewogenen Trainingsdaten arbeitet. Verzweigen Sie den Ablauf dann mit einer IF-Aktivität:- Verarbeiten Sie semi-strukturierte Dokumente mit einer Fast Learning-Aktivität.
- Verarbeiten Sie unstrukturierte Dokumente mit einer Segmentation-Aktivität, gefolgt von einer Deep Learning for NLP-Aktivität.
Tabellenzellen mit im Zelltext eingebetteten Feldern
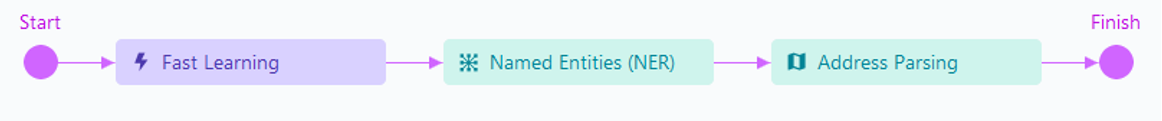
Verwenden Sie dieses Szenario, wenn Sie bestimmte Werte aus Tabellenzellen in semi-strukturierten Dokumenten extrahieren müssen — zum Beispiel den Namen eines Kreditnehmers und Teile einer Adresse, die in einer Closing-Disclosure-Zelle enthalten sind. Extrahieren Sie die Zelle als zusammenhängenden Textblock mit einer Fast Learning-Aktivität und führen Sie dann NLP-Aktivitäten für diesen Block aus, um die eingebetteten Felder zu extrahieren:- Named Entities (NER)-Aktivität für Entitäten wie Namen und Organisationen.
- Address Parsing activity, um Adressen in ihre Bestandteile zu zerlegen.
Unstrukturierte Dokumente mit Tabellen, Titeln, Kopf- oder Fußzeilen
Verwenden Sie dieses Szenario für Dokumente, die größtenteils unstrukturiert sind (zum Beispiel Verträge), aber eingebettete semi-strukturierte Fragmente wie Tabellen, Titel, Kopf- oder Fußzeilen enthalten. Erkennen Sie Textabsätze mit einer Segmentation-Aktivität und die semi-strukturierten Fragmente mit einer Extraction Rules-Aktivität. Sobald jedes Fragment isoliert ist, verwenden Sie die entsprechende Aktivität, um seine Felder zu extrahieren.