Wählen Sie ein Szenario aus
Jedes der folgenden Szenarien folgt demselben Muster; nur die Aktivitäten, die Sie dem Verarbeitungsablauf hinzufügen, unterscheiden sich.
Typischer Workflow
1
Einen Document-Skill erstellen
Öffnen Sie Advanced Designer und klicken Sie auf der Startseite auf Create Document Skill.
2
Dokumente hochladen
Laden Sie auf der Registerkarte Documents die Dokumente hoch, die Sie zum Einrichten des Skills verwenden. Fügen Sie in Szenarien mit Klassifizierung für jede Variante ungefähr gleich viele Dokumente hinzu, damit der Klassifikator ausgewogene Trainingsdaten erhält.
3
Felder definieren und labeln
Erstellen und konfigurieren Sie auf der Registerkarte Fields die Felder, die der Skill extrahieren soll. Labeln Sie die Dokumente im Abschnitt Reference.
4
Aktivitäten hinzufügen und konfigurieren
Fügen Sie auf der Registerkarte Activities die Aktivitäten für Ihr Szenario hinzu (wie unten beschrieben). Öffnen Sie jede Aktivität im Activity Editor, um sie zu konfigurieren und zu trainieren.
5
Testen und veröffentlichen
Klicken Sie auf Test Skill Using Selected Documents, um die Ergebnisse auszuwerten. Wenn die Ergebnisse gut genug sind, veröffentlichen Sie den Skill.
Viele unterschiedliche Dokumentvarianten
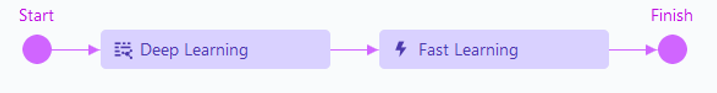
Verwenden Sie dieses Szenario, wenn Dokumente zwar demselben Typ angehören, ihre Layouts jedoch stark variieren — zum Beispiel Rechnungen von vielen Lieferanten, bei denen fortlaufend neue Vorlagen hinzukommen. Kombinieren Sie eine Deep-Learning-Aktivität mit einer Fast-Learning-Aktivität:- Deep Learning generalisiert auch auf bislang unbekannte Varianten. Für das Training sind mindestens 100 annotierte Dokumente erforderlich.
- Fast Learning erhöht die Genauigkeit für die konkreten Vorlagen, die Sie bereits kennen. Es kann außerdem kontinuierlich über die Feedbackschleife der Online Learning aus der Manuellen Überprüfung weiter trainiert werden.
Ausreißer, die eine regelbasierte Extraktion erfordern
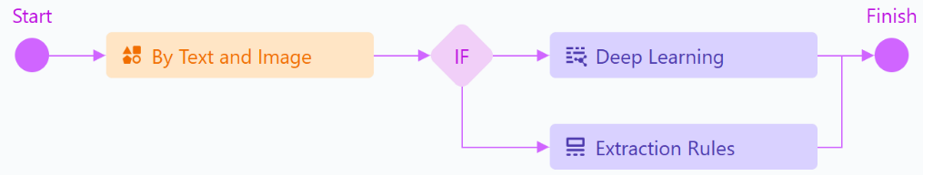
Verwenden Sie dieses Szenario, wenn die meisten Varianten mit Deep Learning + Fast Learning funktionieren, einige wenige Dokumente jedoch verschachtelte Tabellen oder andere Merkmale aufweisen, die sich mit maschinellem Lernen nicht zuverlässig erfassen lassen. Trennen Sie die Ausreißer mit einer Classify activity und verzweigen Sie den Ablauf dann mit einer IF activity:- Verwenden Sie Classify By Company, wenn die Varianten von unterschiedlichen Unternehmen stammen, deren Name oder Adresse auf dem Dokument erscheint — zum Beispiel Kontoauszüge von mehreren Banken.
- Verwenden Sie Classify By Text and Image in allen anderen Fällen. Dieser multimodale Klassifikator nutzt Text-, Layout- und Bildmuster, um Varianten zu unterscheiden.
Begrenzte Trainingsdaten
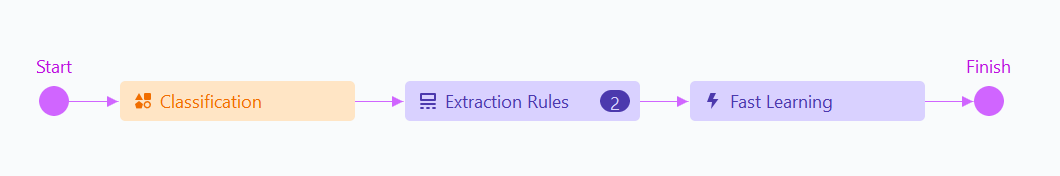
Verwenden Sie dieses Szenario, wenn Sie nicht genügend Dokumente haben, um eine Deep Learning-Aktivität zu trainieren, aber über ausreichend Domänenwissen verfügen, um die Extraktionsregeln zu beschreiben — zum Beispiel bei Steuerformularen, die je nach Jahr variieren. Teilen Sie die Dokumente mit einer Classify activity (Classify By Company oder Classify By Text and Image) auf, und leiten Sie dann jede Variante an ihre eigene Extraction Rules-Aktivität weiter. Optional können Sie eine Fast Learning-Aktivität hinzufügen, damit Vantage den Skill im Laufe der Zeit weiter verfeinern kann.