
- 処理ワークフロー (たとえば、ステージ数)
- 画像補正、認識モード、エクスポート設定などの処理設定
- カスタムエンジン、スクリプトルール、外部リソースへのアクセスを含むカスタムステージの実装
- ハードウェア
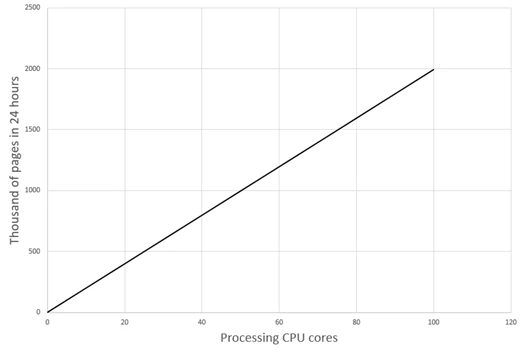
処理コア数に対するパフォーマンスの依存関係
- 無人処理および PDF ファイルへのエクスポートを使用した
SingleEntryPointデモプロジェクト - 白黒ページの場合、2.4 GHz、16 GB RAM、SSD、1 Gb/s NIC を備えた 10 コアの Processing Stations
処理コア数を見積もる
まず、1つのコアで1ページを処理するのにかかる時間を測定し、その値で目標処理量を割ります。- プロジェクトのワークフローを設定し、本番環境の構成に最も近いハードウェアの Processing Station を選択して、典型的な画像バッチを作成します。
- 1つのコアで1つのバッチを処理するのにかかる時間を測定します。バッチを1回だけ処理しても十分ではありません。テスト中は FlexiCapture が利用可能なすべてのコアに処理を分散するため、バッチは本番環境で処理する場合よりも早く完了します。本番環境では、他のコアは別のバッチの処理で使用中です。信頼できる値を得るには、典型的なバッチのコピーを複数作成し、それらをすべて同時に処理します。コピー数は少なくともコア数と同じ数、理想的にはその N 倍 (N ≥ 3) にしてください。1コアあたりの1バッチの処理時間は、総処理時間を N で割った値です。これにはコア同士が ステーション の共有リソースを競合する影響も含まれます。
-
必要なコア数を計算します。
ここで、P は処理するページ数、t は1ページを処理する時間、T は利用可能な時間です。
計算例
- Hyper-Threading を備えた 8 コアの Processing Station では、16 個の論理コア (16 個の実行プロセス) が利用できます。
- 一般的なバッチのコピーを 16 × 3 = 48 個作成し (測定誤差を減らすために ×3) 、それらをすべて一度に処理します。
- 実行時間は 15 分 です。各コアで 3 つのバッチを処理するため、1 つのバッチの処理時間は約 5 分 です。
- このバッチは 69 ページ あるため、1 ページあたり約 4.35 秒 かかります。
- 8 時間で 200,000 ページを処理するには (28,800 秒) 、N = (200,000 × 4.35) / 28,800 ≈ 31 コア となります。
- したがって、自動処理には Hyper-Threading を備えた 8 コアの Processing Station 2 台 (合計 32 論理コア) で十分です。
制限要因
システム で有効に利用できる処理コア数を制限する要因は 2 つあります。インフラストラクチャの負荷
インフラストラクチャ全体の負荷により、次の箇所でボトルネックが発生する可能性があります。- FlexiCaptureサーバーのハードウェア
- ネットワーク
- カスタム処理スクリプトからアクセスされる外部の共有リソース (データベースや外部サービスなど)
Processing Server の処理能力
Processing Server が対応できる処理コア数には上限があります。この上限は、1 つのコアがタスクの実行に要する平均時間によって決まります。タスクの所要時間は、バッチあたりのページ数や実装したカスタマイズに大きく左右されます。通常、1 バッチあたり約 10 ページの場合、Processing Server は 120 個の処理コアに対応できます。 非常に高速なカスタム スクリプトや 1 ページのみのバッチでは、平均タスク時間が大幅に短縮されます。その結果、Server が対応できるコア数の上限がわずかに低下することがあります。 この状況を検出するには、Processing Server の空き処理コア数を監視します。ドキュメントがキューで待機しているにもかかわらず、使用中のコア数が飽和状態にあり、ほとんど増加しない場合は、上限に達しています。解決するには、次の操作を行います。- 可能な場合は、バッチを小さなタスクに分割せず、バッチ全体を処理します (Workflow 設定ダイアログの Stage Properties を参照) 。
- 次のいずれかの方法で、より大きな単位でページを処理します。
- バッチあたりの平均ページ数を増やす
- 複数のカスタム ステージを 1 つに統合する
- カスタマイズを標準ステージに移す。たとえば、そのステージのスクリプト内のルーティング イベントに追加します