- 半構造化文書と非構造化文書の両方 (異なる文書タイプ) を含む 1 つのセット。
- 構造が混在した 1 つの文書。たとえば、埋め込みテーブル、埋め込み field、タイトル、ヘッダー、またはフッターを含む非構造化の契約書です。
シナリオを選択
以下の各シナリオは共通のパターンに従っており、異なるのは処理フローに追加するアクティビティだけです。
一般的なワークフロー
1
Document skill を作成
Advanced Designer を開き、スタート ページで Create Document Skill をクリックします。
2
ドキュメントをアップロード
Documents タブで、Skill の設定に使用するドキュメントをアップロードします。
3
fields を定義してラベル付け
Fields タブで、Skill が抽出する fields を作成して設定します。Reference セクションでドキュメントにラベル付けします。
4
Activity を追加して設定
Activities タブで、シナリオに応じた Activity (詳細は以下を参照) を追加します。各 Activity を Activity Editor で開き、設定して学習させます。
5
テストして公開
Test Skill Using Selected Documents をクリックして結果を評価します。結果が十分に良好であれば、Skill を公開します。
1 つのセット内の半構造化文書と非構造化文書
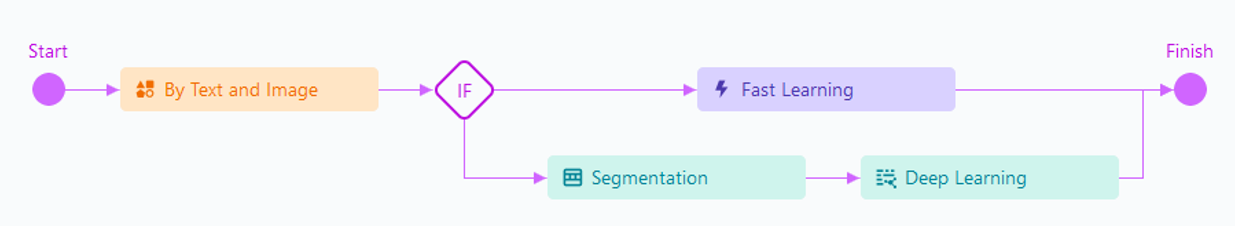
1 つの Document skill で 半構造化 文書と 非構造化 文書の両方を処理する必要がある場合は、このシナリオを使用します。これらはどちらも同じ論理タイプに属し、同じ出力fieldsのセットを共有します。 各文書は、テキストとレイアウト情報を組み合わせて、低品質の画像やグラフィック上の特徴 (署名、印章) だけが異なる文書に対応できる Classify By Text and Image activity で分類します。最良の結果を得るには、分類器がバランスの取れた学習データを得られるように、各バリエーションについておおむね同数の文書をアップロードしてください。次に、IF アクティビティを使ってフローを分岐します。- 半構造化文書は Fast Learning アクティビティ で処理します。
- 非構造化文書は、Segmentation アクティビティ の後に Deep Learning for NLP activity を使用して処理します。
セルテキストにfieldsが埋め込まれたテーブルセル
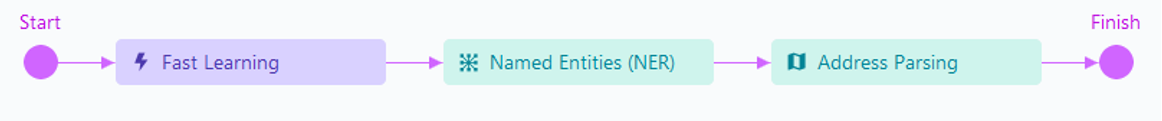
このシナリオは、半構造化文書のテーブルセル内から特定の値を抽出する必要がある場合に使用します。たとえば、Closing Disclosure のセルに埋め込まれた借入人の氏名や住所の一部を抽出する場合です。 まずセルを 1 つのテキストブロックとして Fast Learning アクティビティ で抽出し、その後、そのブロックに対して NLP アクティビティを実行して、埋め込まれたfieldsを抽出します。- 氏名や組織名などの固有表現を抽出するには、固有表現 (NER) アクティビティ を使用します。
- 住所を構成要素に分解するには、Address Parsing activity を使用します。
テーブル、タイトル、ヘッダー、またはフッターを含む非構造化文書
このシナリオは、主に非構造化文書 (たとえば契約書) でありながら、テーブル、タイトル、ヘッダー、またはフッターなどの半構造化要素が埋め込まれている文書に使用します。 プレーンテキストの段落は Segmentation アクティビティ で検出し、半構造化要素は Extraction Rules アクティビティ で検出します。各要素を切り分けたら、適切なアクティビティを使用してそのfieldsを抽出します。