- Segmentation activity
- Deep Learning for NLP activity
- Named Entities (NER) activity
- Address Parsing activity
これらの各アクティビティがサポートする言語は限られています。対応言語の一覧については、各アクティビティのリファレンスページを参照してください。
シナリオを選択する
以下の各シナリオはいずれも共通のパターンに従っており、異なるのは処理フローに追加するアクティビティだけです。
一般的なワークフロー
1
Document skill を作成
Advanced Designer を開き、スタート ページで Create Document Skill をクリックします。
2
ドキュメントをアップロード
Documents タブで、Skill の設定に使用するドキュメントをアップロードします。
3
field の定義とラベル付け
Fields タブで、Skill が抽出する field を作成して設定します。Reference セクションでドキュメントにラベル付けします。
4
NLP アクティビティの追加と設定
Activities タブで、シナリオに必要なアクティビティ (以下で説明) を追加します。各アクティビティを Activity Editor で開き、設定して学習させます。
事前学習済みの固有表現 (文書全体)
必要な固有表現が文書内のどこに現れてもよい場合は、このシナリオを使用します。たとえば、手紙に含まれる会社名や住所などです。固有表現 (NER) アクティビティ を追加し、各固有表現をfieldにマッピングします。さらに、住所を構成要素 (住所、市区町村、州、国、郵便番号) に分解する必要がある場合は、Address Parsing アクティビティ を追加し、それらの構成要素をfieldsにマッピングします。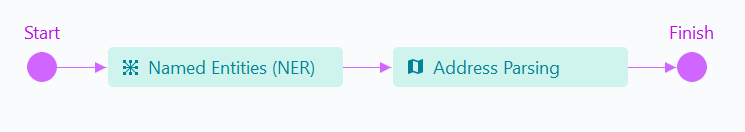
事前学習済みの固有表現 (特定の段落)
このシナリオは、固有表現が常に同じ段落内にある場合に使用します。たとえば、売買契約の価格条項に記載された購入金額です。まず、Segmentation アクティビティでその段落を切り出し、次に切り出した field に対して 固有表現 (NER) または Address Parsing アクティビティを実行します。 また、Segmentation の代わりに Fast Learning または NLP Extraction Rules アクティビティを使用して段落を切り出し、その結果に対して NER または Address Parsing を実行することもできます。
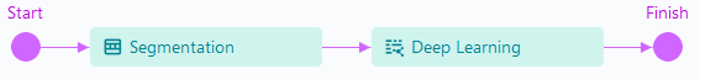
カスタム固有表現 (Deep Learning for NLP)
事前学習済みアクティビティでは必要な固有表現をうまく識別できない場合に、このシナリオを使用します。たとえば、契約の両当事者が記載された段落から一方の組織名だけを抽出する場合や、NER ではカバーされない種類のエンティティ (メールアドレスなど) を抽出する場合です。Segmentation アクティビティ と Deep Learning for NLP アクティビティ を組み合わせてください。Segmentation で段落を切り出し、Deep Learning で目的の field を抽出します。Deep Learning for NLP アクティビティのトレーニングには、少なくとも 50 件の文書 (推奨 150 件) が必要です。最適な結果を得るには、事前学習済みの 固有表現 (NER) アクティビティも試し、お使いの文書に対してより高い精度で抽出できる方を選んでください。