
A
ABBYY FlexiCapture
構造化文書 (固定フォーム) 、半構造化文書 (flexible forms and documents) 、非構造化文書 (free-format documents) から単一のフローでデータを抽出するためのソフトウェアソリューション。ABBYY FlexiCapture for Invoices
請求書を処理するためのソフトウェアソリューションです。詳細については、ABBYY FlexiCapture for Invoicesを参照してください。ABBYY FlexiLayout Studio
文書の構造を記述する FlexiLayout を作成するためのプログラムです。作成した FlexiLayout は、自動文書認識に利用できます。ABBYY FormDesigner
機械可読フォームのレイアウトを設計するためのプログラムです。設計したフォームを複製して記入すると、ABBYY FlexiCapture 自動フォーム入力システムで処理できるようになります。 フォームレイアウトの設計は重要なステージです。レイアウトの品質、つまり機械可読性によって、後続のすべての処理ステージ (スキャン、認識、検証、エクスポート) の効率が左右されます。ADF
自動原稿送り装置。文書を自動的に給紙する装置で、追加の手動操作を行うことなく、任意の枚数の文書をスキャンできます。管理者
ABBYY FlexiCapture のユーザーのうち、ドキュメント入力用にプログラムを設定する権限を持つユーザー。たとえば、Document Definitions およびインポートプロファイルの作成や編集などを行います。アルファベット
説明されている言語で使用される文字の集合です。アンカー
スキャン後にシステムがマッチングに使用する、フォーム設計上の特殊な要素です。マッチングにより、傾きの補正、線形および非線形のスキャン歪みの補正、ブロックの位置の算出が行われます。 最も信頼性の高いアンカーは黒い四角形で、通常はフォームの四隅に配置されます。画像に専用のアンカーがない場合は、他の静的要素を使用して文書定義の照合を行うことができます。- 区切り:テーブルの罫線や枠などの垂直線または水平線
- 明確な静的テキスト:フォームの見出し、field のキャプション、説明文など
アンカーバーコード
データ抽出を目的としないバーコードを表す静的要素です。アンカーバーコードは、Document Definition のマッチングや識別に使用できます。アンカーテキスト
空白フォーム上に存在し、データ抽出を目的としないテキストを表す静的要素です。説明文や見出しなどのテキストが該当します。アンカーテキストは、文書定義の照合や識別に使用できます。角
角形の基準マーク。別紙
フィールドを含まないものの、ドキュメントのアセンブリに含まれるページです。これらのページからデータは抽出されませんが、画像または検索可能な PDF ファイルとして保存できます。詳細については、次を参照してください: 別紙を含む文書の Document Definitions の作成。アセンブリ エラー
ドキュメント アセンブリ中に作成されたドキュメントに他のドキュメントのページが含まれている場合、またはそのドキュメントのページの順序が正しくない場合に発生するエラーです。このエラーは、ドキュメント内のページで主要項目の値が一致しない場合にも発生します。自動学習
ABBYY FlexiCaptureが新しいfieldの検出と文書タイプの識別を自動的に学習する機能。B
バーコード
所定の長さの白黒のバーが交互に並んで構成された、デジタル情報を符号化する機械可読なフォーム要素です。文書内のバーコードは、情報の抽出 (Barcode フィールド) や、Document Definition の照合と識別 (アンカーバーコード) に使用できます。Barcode フィールド
認識対象のバーコードを含む Document Definition の field。バーコード認識
バーコードの画像を数値またはテキストに変換すること。バッチタイプ
このタイプのバッチ内の文書をどのように処理するかを定義する、バッチプロパティ。詳細については、バッチタイプを参照してください。白黒罫線フォーム
情報fieldの境界が、スキャンしても消えない通常の線で構成されたフォームです。黒い四角
黒い四角形のアンカー。明るさ
スキャナがグレースケールの中間調を白として検出する境界を決める、光感度のしきい値です。C
チェックマーク
記入者がチェック、バツ、点などの印を付けたり、塗りつぶしたりする、機械可読なフォーム要素です。チェックマーク field
チェックマークを含む Document Definition の field。チェックマークグループ
互いに近接して配置された複数のチェックマークを1つのまとまりとして扱う、機械可読な帳票の要素です。チェックマークグループでは、1つまたは複数のチェックマークを選択できます。チェックマークグループfield
チェックマークグループを含むDocument Definitionのfield。分類器
FlexiLayout Studio で作成されるプロジェクトで、Document Definitions を適用する前にページを識別するためのものです。分類器は、対応する FlexiLayout または代替レイアウトの選択にも使用されます。分類器のF値
ドキュメント分類における適合率と再現率を組み合わせた指標です。0~1の数値、または0%~100%のパーセンテージで表されます。 F値は、カテゴリに対しても、テスト用バッチや学習用バッチに対しても、次の同じ式で計算されます。
最大値は 1 (100%) で、P = R = 1 (100%) のときにこの値になります。
コードページ
特定の言語の文字セットを定義する値のテーブル。色付き背景のフォーム
スキャン時に消える色付きの背景上に、すべての情報fieldが白い矩形として配置されているフォーム。コントラスト
画像の最も暗い部分と最も明るい部分の明るさの比率。コントロール
データ フォーム上のテキスト、field、またはボタンの要素。詳細については、Document Definition エディター メニューの Insert Control コマンドを参照してください。修正済みチェックマーク
誤って選択され、その後に抹消されたチェックマークです。チェックマーク field で [修正を許可] オプションが有効になっている場合、プログラムは抹消されたチェックマークを未選択として認識します。十字
十字形のアンカー。カスタムデータ型
ユーザー定義のデータ型。詳細については、カスタムデータ型の作成を参照してください。D
データベースルックアップ
認識されたデータを対応するデータベースレコードと照合すること。データセット
自動文書チェックに使用されるデータです。データセットは、ABBYY FlexiCapture にテーブルとして保存してスケジュールに従って同期できます。また、外部ソースから取得することもできます。データ型
field に含まれるデータの種類を指定する field の特性です。データ型には、数値、日付、テキスト、姓、名、住所などがあります。データ型は、その field に現れる可能性のある単語の集合を定義します。 データ型は、認識精度に影響する重要な認識パラメーターです。データ型を正しく指定すると、誤認識される文字数を大幅に減らすことができます。説明ファイル
Hot Folder から画像を追加する際に、バッチの作成方法を定義する補助ファイルです。詳細については、説明ファイルを参照してください。辞書
認識および検証の際に、プログラムが field に対して使用する単語のセットです。辞書はデータ型の作成時に指定するため、field の辞書は、その field にアタッチされたデータ型によって決まります。 既成の辞書を備えた事前定義のデータ型のほか、カスタム辞書に基づくデータ型をアタッチすることもできます。辞書データは手動で入力することも、ファイルからロードすることもできます。ドキュメント
1つ以上のページ画像と、そこから抽出されたデータを組み合わせたものです。文書バッチ
ユーザーがまとめた文書のグループです。通常、バッチには1回のスキャンで取り込まれた一連の文書、または特定のフォルダーからインポートされた文書が含まれます。詳細については、次を参照してください:Batches。ドキュメントクラス
複数の共通する特性を持つ文書またはページの集合です。文書データ
処理 (認識、検証、認識結果の編集を含む) を経て、文書ページ画像から抽出されるデータ。Document Definition
特定の種類の文書をどのように識別して処理するかを指定する定義です。Document Definition には、次の内容が含まれます。- 文書構造。この種類の文書で許可されるページ順序を記述し、文書の組み立て方を定義します
- 文書セクションの定義
- field データが満たすべきルールの一覧
- データ ウィンドウ (データ フォーム ビュー) 内の field とそのキャプションの位置
- 文書のエクスポート設定
- 文書処理設定
Document Definition の識別
識別子を使って、必要な Document Definition を特定するプロセスです。文書定義の照合
Document Definition を選択し、その field を画像に対してマッチングするプロセス。Document Definition の公開
編集後の新しい Document Definition バージョンを利用可能にすること。公開済みバージョンは作業バッチ内のドキュメントの処理に使用されます。未公開のローカルバージョンは、テストバッチ内のドキュメントの処理にのみ使用できます。詳細については、Document Definition の編集と公開を参照してください。Document Definition セクション
Document Definition の構成要素で、論理的に完結した一連の field を含む 1 ページまたは複数ページに対応します。1 つのセクション内の field は、複数ページにまたがるテーブルのように、ページをまたいで続くことがあります。異なるセクションの field セットが重複することはありません。 セクション定義は、flexible または fixed にできます。文書識別
文書を、あらかじめ定められた複数の文書タイプのいずれかに割り当てる処理。文書セット
特定の目的のために使用される、論理的に関連した文書の集まりです。たとえば、業務プロセスは、申請者から提出される一式の文書 (記入済みの申請書と、それに添付するいくつかの文書など) によって開始されることがあります。申請書に記入された情報によっては、添付文書の一部は任意となる場合がありますが、申請書に必ず添付しなければならない文書もあります。ドキュメントのテキスト
FlexiLayout が適用される前の予備認識の段階でドキュメントから抽出された、すべてのテキストです。このテキストを保存しておくと、検証の際に使用できます。保存するには、ハードディスクに追加の空き容量が必要です。文書タイプ
いくつかの共通する特徴を持ち、業務プロセスにおいて特定の役割を果たす文書のグループです。文書タイプの例としては、請求書、契約書、パスポートなどがあります。文書バリアント
同じ種類に属し、いくつかの特徴を共有する文書のグループ。文書バリアントの例としては、異なるベンダーの請求書や、同じ銀行のクレジット明細書があります。ドットマトリクスプリンター
ドットマトリクスプリンターで印字された、認識可能なテキストの一種です。dpi
dots per inch の略。画像解像度の単位です。E
エンティティ
NLP 技術を使用して抽出する情報を含む field または field グループを指します。エンティティの例としては、人、企業、場所、金額、日付などがあります。環境変数
テキスト (システム設定など) を保存するための文字列です。環境変数には、データベース接続文字列や、エクスポートするファイル名の指定に使用する変数を保存できます。エラーまたは警告
エラーまたは警告は、1 つ以上の field から抽出されたデータが、自動チェックで適用されるルールを満たさない場合に発生します。また、データが指定された形式に一致しない場合にも発生します。エラーおよび警告には、次の 2 種類があります。- 単一 field のエラーおよび警告は、1 つの field を対象とするルールおよび形式によって生成されます。
- 複数 field のエラーおよび警告は、複数の field を対象とするルールによって生成されます。
説明テキスト
フォーム名、field名、fieldの説明などの説明テキストを表す、機械可読なフォーム要素です。エクスポート
処理済みデータを外部の情報システムまたはファイルに転送する処理。エクスポートプロファイル
処理済みデータの扱いを決める設定一式です。出力ファイルの形式、出力先パス、エクスポート条件などを指定します。外部データベース
参照データを格納するテキストファイル、または ODBC 対応データベースです。参照データには、抽出された field の取り得る値や、field の抽出に必要な情報を含めることができます。F
Field
データ抽出を目的としたドキュメントの要素です。field には、単純なもの (内部構造を持たないもの) と複合的なものがあります。たとえばテーブル field では、各セルをテーブルに属する個別の従属 field と見なすことができます。詳細については、Document Definition field を参照してください。field 領域
Document Definition で強調表示され、データ抽出の対象となる画像領域です。field検証
不確かな文字を field全体の文脈の中で確認する検証モードです。Send to field verification オプションが有効になっている fieldは、field検証に送られます。 国名や都市名など、値の範囲がわかっている、または容易に特定できる fieldには field検証を使用してください。詳細については、次を参照してください: field検証。複数のインスタンスを持つ Field
同じ型の複数のオブジェクト (繰り返し現れるオブジェクト) を表すために使用されるFieldです。これらのオブジェクトは1つの同じFieldであり、同じプロパティを共有します。複数のインスタンスを持つFieldを使用すると、同一のFieldを複数作成する必要がなくなります。 複数のインスタンスを持つFieldは、個別のファイルまたはデータベーステーブルにエクスポートされます。詳細については、複数のインスタンスを持つFieldを参照してください。複数の領域を持つ Field
画像上の複数の領域から構成される field です。こうした領域は、互いに離れた位置に存在する場合があり、別々のページにあることもあります。同じ field のすべての領域の値は結合され、1 つの field としてまとめてエクスポートされます。 この種類の field は通常、大きなテーブルのように複数ページにまたがるオブジェクトに使用されます。詳細については、複数の領域を持つ Fieldを参照してください。領域のない field
Document Definition で指定されているものの、画像上に領域を持たない field。詳細については、次を参照してください: 領域のない field。Fixed Document Definition
fixed forms を処理するために設計された、ドキュメントまたはそのセクションの定義です。fixed Document Definition の field は、位置が固定されています。固定フォーム
書式、数、レイアウトが厳密に定義されており、文書ごとに変わらない固定情報のfieldを持つ文書。FlexiLayout
半構造化文書の構造を記述したものです。この記述は ABBYY FlexiLayout Studio で作成し、ABBYY FlexiCapture にエクスポートします。ファイル形式は*.afl です。
FlexiLayout は、柔軟なフォーム内の field を検出して識別するための一種の定義です。
FlexiLayout バリアント
特定の文書バリアント向けに開発された、またはその文書バリアントを基に学習された FlexiLayout。FlexiLayout バリアントは汎用 FlexiLayout と組み合わせて使用されます。Flexible Document Definition
半構造化文書の処理用に設計された、文書またはそのセクションの定義です。FlexiLayoutをアタッチして作成します。flexible Document Definition の fieldは FlexiLayout によって検出されるため、固定位置がありません。詳細については、flexible 記述に基づく Document Definition の作成を参照してください。帳票
手書きまたはその他の印字方法で人が記入するために作成された、1ページまたは複数ページで構成される文書。枠付きテキスト
枠で囲まれたテキストを示すテキストマーキングの種類です。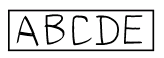
櫛形枠の上にある枠付きテキスト
櫛形枠のある枠内にテキストを入力する、テキストマーキングの一種です。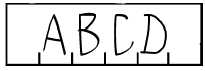
G
灰色の背景のフォーム
すべての情報fieldが、スキャン時に消える灰色の背景上に白い矩形として配置されたフォームです。グループ検証
同一の値として認識された文字画像をグループ化し、まとめて表示して目視で確認できるようにする検証モードです。グループ検証に送信 オプションが有効になっているfieldは、グループ検証に送信されます。 数値field内の文字とチェックマークには、グループ検証を使用してください。詳細については、次を参照してください: グループ検証。H
手書きの活字体文字
判読可能なテキストの一種で、一文字ずつ区切って手書きされた文字を指します。手書き文字
文字が完全に、または部分的につながっている、認識可能なテキストの一種です。認識できる手書きテキストは英語のみです。Hot Folder
ローカルまたはリモートのコンピューターのハードドライブ上にあるフォルダーで、画像のインポートに使用されます。通常、ユーザーの操作を必要としない、定期的に繰り返し行われる画像のアップロードに使用されます。詳細については、画像インポートプロファイルを参照してください。I
ICR (Intelligent Character Recognition)
手書き風文字を認識するための技術やシステムです。手書き風文字の文字や数字が記入された文書を大量に処理するために設計されています。識別子
アンカーの位置が同じ複数のDocument Definitionsの中から、特定のDocument Definitionを確実に選択するために使用する静的要素です。このような静的要素のプロパティで、Document Definition の識別に使用オプションを有効にしてください。ID プロバイダー
Azure AD、OneLogin、Okta などのサードパーティ システムで、ID 情報を管理し、クライアントに認証サービスを提供するものです。ID プロバイダーを使用すると、ユーザーは認証情報を一度入力するだけで、ローカル エリア ネットワーク内のアクセスを許可されたすべてのリソースにアクセスできます。無視文字
単語がデータ型に関連付けられる際に、単語から除外される文字です。無視文字は、ハイフンやアクセント記号のように、検証に影響を与えずに単語内に出現する可能性がある文字です。Image
紙の文書のページをスキャンして得られる電子画像。画像のノイズ除去
画像内のノイズを除去します。ノイズはスキャン時に発生することがあり、除去することでデータ認識の精度が向上します。ノイズ除去の際には、プログラムはラスター形式のフォームの背景のドットや枠線も削除します。画像のインポート
処理のために画像をバッチに追加する処理です。画像は、ファイルやスキャナから、またはインポートプロファイルを使用してインポートできます。詳細については、次を参照してください: ページ画像の追加。画像の回転
画像の中心を軸とした回転です。インポートプロファイル
画像をバッチに追加する際に使用する設定の組み合わせです。インポート元、画像処理オプション、Hot Folder のクリーンアップ オプションなどが含まれます。詳細については、画像インポート プロファイルを参照してください。インデックスフィールド
文書の並べ替えや検索のためのインデックスとして使用される値を持つfieldです。詳細については、次を参照してください: インデックスフィールド。反転画像
暗い背景に明るい色の文字が表示された画像。請求書
納入された商品と、その数量、価格、および特性 (色や重量など) を記載した文書です。請求書には、出荷条件および当事者に関する詳細も記載されます。 請求書は、ABBYY FlexiCapture for Invoicesという別個のソリューションで処理できます。詳細については、ABBYY FlexiCapture for Invoicesを参照してください。K
主要field
ページをドキュメントへ自動的にアセンブリする際のチェックに使用されるfieldです。主要fieldの値は、同じドキュメント内のすべてのページで一致している必要があります。L
言語 (ローカル)
文書の記載言語と、それに対応する地域パラメーターのセット (日付や住所の表記形式など) を決定するfieldプロパティ。Layout
文書画像上のfieldの位置。Layoutは自動生成することも、手動で作成することもできます。関連用語については、Reference layoutを参照してください。枠内の文字
連結した枠の中に文字を記入するテキストマーキングの一種です。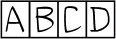
個別の枠内の文字
文字を個別の枠内に記入するテキストマーキングの一種です。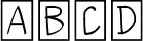
櫛形枠に重なった文字
櫛形枠の上に文字を記入する形式のテキストマーキングです。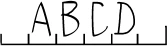
M
機械印字されたテキスト
活字組版機器、レーザープリンター、またはインクジェットプリンターで、解像度 300 dpi 以上で印刷された認識可能なテキストの一種です。機械可読フォーム
自動入力向けに特別に設計されたフォームです。正常に処理するために必要な要素 (アンカー、バーコード、行など) が含まれています。手動入力field
認識できないテキスト (たとえば、文字が癒着したテキスト) を含み、キーボードから入力する必要がある Document Definition のfield。等幅テキスト
各文字が同じ高さ・幅の枠内に収まっているタイプのマーキングです。スキャン時には枠線が消えます。MRC (Mixed Raster Content)
テキストとラスター片の両方を含む画像に使用される圧縮方式です。画像をフラグメントに分割し、各フラグメントに最適な圧縮アルゴリズムを選択します。この方式では、画像の見た目の品質を維持しながら、より高い圧縮率を実現できます。複数ページの文書
複数のページから成る文書。マルチテナンシー
複数の独立したユーザーが ABBYY FlexiCapture を利用できるようにする機能です。各テナントのデータは他のテナントから完全に分離されており、システムは各テナントにリソースの一部を割り当てます。N
NER (固有表現認識)
非構造化テキスト内の属性を検索し、それらを事前定義されたカテゴリに分類する情報抽出タスクです。NLP (自然言語処理)
人工知能および数理言語学の一分野で、自然言語のコンピューターによる解析と生成を扱います。応用例の 1 つとして、テキストから意味のある情報を抽出することが挙げられます。NLP には、機械翻訳、チャットボット、分類、感情分析、データ抽出も含まれます。NLP モデル
テキストからどのエンティティやセグメントをどのように抽出するかを決定する仕組みです。NLP モデルの学習時に、対象領域と抽出アルゴリズムが選択されます。O
OCR (光学文字認識)
印字テキストの光学認識。OMR (光学式マーク認識)
ABBYY FlexiCapture が、フォーム上の通常のマーク (チェック、バツ印など) を高い精度で認識できるようにする技術です。また、誤って付けた後でインクで塗りつぶされたマークも正しく識別できます。オペレーター
ABBYY FlexiCapture のユーザーで、ドキュメント入力を担当し、画像の追加、認識と検証の実行、認識済みデータのエクスポートなどを行うユーザー。オペレーター ロール
ABBYY FlexiCapture におけるユーザーアカウントのプロパティです。ユーザーがアクセスできるデータや、それらのデータに対して実行できる操作を定義します。詳細については、設定済みプロジェクトを運用するを参照してください。オーバーレイ
Document Definition エディターで、記入済みフォームのスキャン画像と、同じ空白フォームの画像を重ね合わせる処理。P
ページ
紙の文書ページの画像とその処理結果。ページレイアウト
画像上のfieldの位置を示す図。ページの向き
標準的な配置 (上から下、左から右) を基準としたページの位置です。ページの向きは、ページ画像の認識時に自動で検出できます。そのために、ABBYY FlexiCapture ではページが取り得る向きを指定できます。画像
認識の対象ではなく、グラフィックオブジェクト (ファイルなど) としてエクスポートすることを目的とした、機械可読フォームの要素です。画像field
画像を含む Document Definition のfieldです。適合率
自動分類の精度を評価するための指標です。クラス A と判定されたすべての文書数 (正しく判定されたものと誤って判定されたものの両方) に対する、正しくクラス A と判定された文書数の割合です。事前認識
Document Definition による field 検出を容易にするための文書画像の全文認識。処理能力
特定の期間内に処理されたページ、ドキュメント、またはバッチの平均件数。処理ステージ
分散インストールにおいて、文書またはバッチに対して特定の操作が行われるワークフローのステージです (自動的に、またはオペレーターによって実行されます) 。詳細については、処理ステージとキューを参照してください。禁止文字
field に出現しないことがわかっている文字です。禁止文字を指定すると、認識速度と認識品質が大幅に向上することがあります。たとえば、大文字のみのテキストを認識する場合は、すべての小文字を禁止文字として指定します。プロジェクト
ドキュメントバッチと、それらを処理するために必要な ドキュメント定義、インポートプロファイルなどの設定をまとめた単一の環境です。詳細については、プロジェクトの作成を参照してください。Q
キュー
分散インストールにおいて、タスクまたはバッチにまとめられ、特定の処理ステージで処理待ちになっている文書。詳細については、処理ステージとキューを参照してください。R
ラスターフォーム
情報fieldが、ラスター線から成る灰色の背景上の白い矩形として、またはラスター線で区切られた矩形として表されるフォーム。ラスター線
等間隔のドットで構成される線。再現率
自動分類の精度を評価するための指標です。正しく識別されたクラス A の文書数を、クラス A に属する全文書数で割って算出されます。認識
画像要素を特定の文字と照合する処理です。認識言語
ABBYY FlexiCapture がテキスト認識に使用する言語です。参照クラス
手動分類の際に専門家が文書に割り当てたクラスです。文書内のセクションも文書バリアントも、参照クラスになり得ます。Reference layout
自動的に作成されるレイアウトの参照として使用される、ユーザー作成のレイアウトです。この比較は、プログラムがfield regionをどの程度正確に検出できているかを評価するために行われます。正規表現
特殊な言語で記述された、単語や入力された任意の値の構造の記述です。正規表現を使用すると、使用可能な文字の集合に加えて、field の内容の構造も指定できます。 テキスト field の制約を設定する場合や、カスタムデータ型を作成する場合は、正規表現を使って構造を記述できます。詳細については、正規表現で使用されるアルファベットを参照してください。解像度
1 インチあたりのドット数 (dpi) で表される画像パラメーター。結果クラス
自動分類時にドキュメントに割り当てられたクラスです。ルールの検証
認識されたデータを事前設定されたルールに照らして自動的にチェックすることです。詳細については、次を参照してください: ルールとフォーマット エラー。ルール
field のデータに対して設定され、プログラムによって自動的にチェックされる特定の条件。詳細については、次を参照してください: ルールの検証。S
スキャン
スキャナを使用して、紙のフォームを電子画像として取り込むプロセス。セクション
文書内で論理的に区別される部分で、抽出可能な field のセットを含みます。セクションは、ページをまとめて文書を構成するなど、認識中のさまざまな目的で使用されます。セクションには 1 ページのみを含めることも、複数ページを含めることもでき、fixed または flexible にできます。詳細については、複数ページ文書用の ドキュメント定義 を作成するを参照してください。セグメント
抽出対象のデータを含む、1つ以上の段落で構成されるテキストフラグメント。セグメントは、抽出対象のfieldである場合もあります。たとえば、契約終了の条件などがこれに該当します。セグメンテーション
セグメントを特定するプロセス。セグメンテーションは情報抽出に先立って行われます。大きな文書では、エンティティの検索対象を特定のテキストフラグメントに絞り込めるため有用です。半構造化文書
文書ごとに、情報フィールドの構成、数、レイアウトが大きく異なる場合がある文書。詳細については、ABBYY FlexiCapture で処理できる文書の種類を参照してください。区切り線
縦線または横線を表す機械可読なフォーム要素です。サービス field
文書画像上に領域を持たない field。サービス field の値は、そのプロパティで指定された source のデータに基づいて自動的に決定されます。詳細については、サービス fieldを参照してください。使用可能な文字のセット
field に出現する可能性のある文字のセットです。認識時に使用される文字のセットは、field にアタッチされたデータ型によって決まります。 このセットに含める文字を選択するだけでなく、以下を指定してセットをさらに絞り込むこともできます。- 禁止文字:field の認識時に出現しないことがわかっている文字です。たとえば、大文字しか出現しない field では、すべての小文字を禁止文字として指定できます。
- 無視文字:単語内に出現しても、その単語の検証に影響しない文字です (ハイフンやアクセント記号など) 。
シンプルテキスト
区切り記号を使わずにブロック内へテキストを挿入する、テキストマーキングの一種です。単一フローでのデータ入力
紙文書 (印刷物) およびデジタル文書 (スキャン画像) からの自動データ抽出。単一フローでの文書入力
紙文書を電子化する自動変換。SLA (サービスレベル契約)
ITサービスの提供に関する取り決め。ABBYY FlexiCapture では、SLA によってバッチの処理期限が定められます。Static elements
Document Definition のマッチングと識別に使用される、認識対象ではない要素です。静的要素には、アンカー、アンカーテキスト、区切り線、アンカーバーコードがあります。概要セクション
文書セット内の主要なフィールドをすべて表示する文書定義セクションです。オペレーターは、セット内のすべてのエラーと low-confidence データを一か所で確認できます。そのため、文書を一つずつ開かなくても、レビューが必要な文書だけを開けば済みます。T
テーブル
必ずしも可視ではない、2 次元のグリッド状に配置されたデータ。プログラムは、同じ型のデータで構成された列と、繰り返される行からなるテーブルを処理します。テーブル field
テーブルを含むDocument Definitionのfieldです。これは複合fieldであり、テーブルの各列は、テキスト、チェックマーク、バーコード、画像など、同じ型のfieldのセットを表します。タスク
分散インストールにおいて、同じバッチに含まれる文書をまとめて処理するためのセットです。プロジェクトの設定や処理ステージに応じて、1つのタスクに含まれる文書数は異なる場合があります。処理ステージでバッチ全体を処理する必要がある場合は、バッチ全体がそのタスクに含まれます。 検証タスクが自動的に作成される場合、各タスクには10件の文書が含まれます。バッチ内の未検証の文書が10件未満の場合は、それらすべてが1つのタスクとして処理されます。テナント
他のユーザーの環境とは独立して利用できる、ABBYY FlexiCapture の独立したインスタンスです。テストバッチ
ドキュメント定義のテストと設定用に設計されたドキュメントバッチです。テストバッチの処理には、ドキュメント定義のローカルコピーが使用されます。詳細については、Batchesを参照してください。Text field
フォームに記入する際に、テキストを入力するために設計された機械可読のフォーム要素。Text field のマーキング
Text field を区切る図形要素 (枠、櫛形枠、line など) 。テキストマーキング
テキスト入力用のページ領域のデザイン。文字記入枠の種類のサンプルについては、Entry field を参照してください。テキストの向き
ページに対するfield内のテキストの向き。テキスト認識 (OCR、ICR)
画像をテキストに変換すること。テキストサンプル
アルファベットのすべての文字のサンプルが含まれたファイル。学習 (Document Definition)
ABBYY FlexiCapture for Invoices の機能の 1 つで、特定の種類の請求書からデータを抽出できるように、プログラムを学習させることができます。学習によりデータ抽出の品質が向上します。プログラムの学習は、プログラムの設定時にも請求書の処理中にも実行できます。学習用バッチ
特定の文書バリアント向けの Document Definition の学習とテストに使用する文書のバッチです。学習用バッチを使って Document Definition を学習させると、FlexiLayout バリアントが作成されます。関連用語については、ドキュメントバッチ、文書バリアント、FlexiLayout バリアントを参照してください。Typewriter
タイプライターで印字された、認識可能なテキストの種類です。U
認識が不確かな文字
認識の確実性が著しく低い場合に、認識処理中の文字にプログラムが自動的に割り当てるステータスです。下線付きのテキスト
線の上にテキストを記入する形式のテキストマーキングです。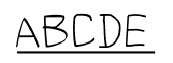
認識対象外の領域
認識から除外された画像領域です。field の認識を難しくする説明テキストや画像を除外するには、認識対象外の領域を使用します。詳細については、認識から領域を除外するを参照してください。非構造化文書
自由形式で情報が記載された文書です。このような文書の例として、契約書、手紙、注文書、グラフなどがあります。詳細については、半構造化文書および非構造化文書のドキュメント定義の作成を参照してください。ユーザー辞書
ユーザーが作成する補助辞書で、組み込み辞書には含まれていない単語を収録します。組み込み辞書をユーザー辞書で補完することで、データ抽出の品質を向上させることができます。通常、ユーザー辞書には、専門用語、略語、会社名が含まれます。V
ベンダー
商品やサービスを販売する法人または個人です。ベンダーは、商品やサービスに対する請求書を発行します。請求書のデータは、ABBYY FlexiCapture for Invoices を使用して抽出できます。検証
データが正しく認識されているか、ページが正しくドキュメントに組み立てられているか、またルールがエラーを返していないかを確認するプロセスです。スタンドアロンインストールでは、検証はオペレーターステーションで行います。分散インストールでは、検証は次の 2 つのステーションで行います。- データ検証ステーション:認識精度を確認します
- 検証ステーション:あらゆる種類のチェックを実行できます
W
作業バッチ
データ入力用のドキュメントバッチです。作業バッチの処理には、公開済みの ドキュメント定義 のみが使用されます。詳細については、Batchesを参照してください。筆記スタイル
帳票内の手書き風文字の筆記スタイルを設定するためのオプションです。選択する筆記スタイルは、帳票処理を行う地域 (ロシア、ドイツ、チェコ共和国、USA など) によって異なります。X
XFD
XML Form Definition (*.xfd) の略で、ABBYY FormDesigner で設計されたフォームのファイル形式です。XFD ファイルは、ABBYY FlexiCapture で ドキュメント定義 を作成する際に使用します。