
GroupSample.fsp sample プロジェクト
GroupSample.fsp プロジェクト (フォルダー %public%\ABBYY\FlexiCapture\12.0\Samples\FLS\Tips and Tricks\Group\Project1) は、グループ要素をどのように使用できるかを示しています。目的は、画像上の請求書番号、請求日、合計金額のフィールドを検出することです。
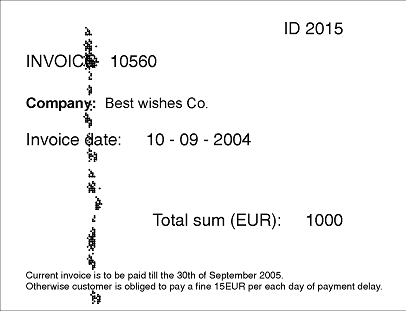
請求書のフィールドをInvoiceRequisiteGroupにグループ化する
画像が示すように (そしてこれは一般にあらゆる財務文書に当てはまりますが) 、文書の番号と日付は隣接するフィールドです。別の文書でフィールドの配置が異なっていても、これらはやはり互いに近い位置にあります。 さらに、これらは文書上の論理的なつながりも持っています。つまり、これらは特定の明細を表し、1つの論理ブロックを構成しているからです。FlexiLayoutの構造をより明確にするため、このプロジェクトではこれらをInvoiceRequisiteGroupという名前のグループ要素にまとめています。要素をグループ化する前に、特別な識別要素が作成されました。 (識別要素については、ABBYY FlexiCaptureでのFlexiLayoutの識別と処理で詳しく説明されています。) この要素は、その中にグループ要素がある場合とない場合で、仮説ツリーがどのように「分岐」するかを示すためだけに作成されたものです。ツリー内のすべての要素は、識別要素を除いて省略可能であり、それらのヌル仮説のデフォルトの品質は0.97であると仮定します。
要素の設定については、ここでは説明しません。プロジェクト内で直接確認できます。
グループ が最良の仮説チェーンを選択する方法
次に、batch 内の テスト画像 で FlexiLayout のマッチングを試してみましょう。 Match コマンドを選択して FlexiLayout のマッチング手順を開始した後、仮説ツリーが 1 本のチェーンだけで構成されていることがわかります。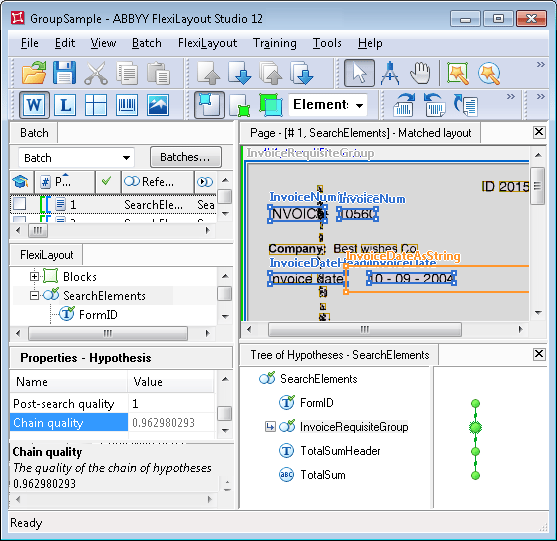
仮説ツリーは 1 本のチェーンだけで構成されています。グループ の品質は、グループ 内で最良のチェーンの品質と一致します。
Post-search relations はどの要素にも指定されていないため、各要素の Post-search quality は = 1 であり、任意の仮説の品質は Pre-search quality で判断できます。
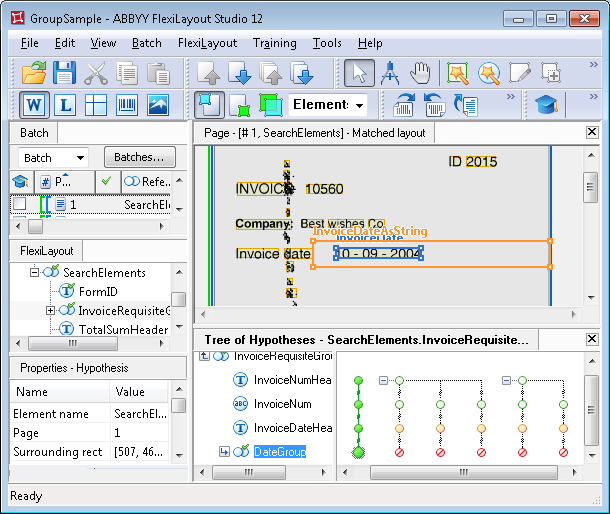
最良の仮説の検索は グループ 内で行われます。すべてのチェーンの品質が解析され、比較されます。グループ の品質は、グループ 内で最良のチェーンの品質によって決まります。
初期品質が低くても正しいチェーンが勝つ理由
前述のとおり、InvoiceDateHeader 要素のプロパティでは、請求書番号の行の下を検索するよう指定しました。しかし、最良の品質を持つチェーン (チェーンの品質 = 1) ではどれも、日付フィールド名の仮説は得られませんでした。そのため、これらのチェーンでは InvoiceDateHeader 要素に対してヌル仮説が生成されました。 ヌル仮説のデフォルト品質を変更していないため、対応するチェーンの最終的なチェーンの品質は 0.97 に低下しました。一方、最も品質の低いチェーンでは、日付フィールド名に対応する要素が見つかりました。その仮説の品質は約 0.993 です。 これが 1 未満なのは、名前の領域の画像にノイズがあるためで、その結果、認識エラーが発生し、認識されたテキストと InvoiceDateHeader 要素のプロパティで指定された値との一致が不完全になったためです。その結果、見つかった仮説には減点が適用され、最終的な品質は約 0.98 になりました (0.99 と 0.993 を乗算した結果) 。 それでも、この仮説の最終品質は他のもの (0.97) より高いため、この段階ではこのチェーンが最良です。 日付フィールドを検出するために、この Project ではグループ要素 DateGroup を使用します。これは、一方の要素が見つかった場合、もう一方の要素の少なくとも 1 つは見つからないよう指定するものです (Dontfind function を使用) 。
ドキュメントの layout 上の特徴と、InvoiceDateAsString 要素に指定したプロパティ (そのアルファベットは数字を許可する) により、FlexiLayout Studio はすべてのチェーンについて日付フィールドを見つけることができましたが、3 つの仮説のうち実際に正しいのは 1 つだけです。
各 グループ では一方の要素が見つかり、もう一方が見つかっていないため、DateGroup グループそれぞれのチェーンの最終品質は 0.97 です (1 にヌル仮説のデフォルト品質 0.97 を乗算した値) 。
この例では、DateGroup チェーンの最終品質は、InvoiceDateHeader 要素を検出する時点での仮説間の「バランス」に影響しません。つまり、各チェーンの品質にはさらに 0.97 が乗算されます。
最終的に、FlexiLayout Studio はグループ要素 InvoiceRequisiteGroup に対して 1 つの仮説を生成しました。これは グループ 内で最良のチェーンに対応しています。その品質は約 0.953 であり、つまり「グループアプローチ」によって、初期品質が低かったにもかかわらず正しい仮説が勝つことができました。
グループ要素のない仮説ツリー
FlexiLayout でグループ要素を使用しない場合に仮説ツリーがどのようになるかを確認するには、Group\Project2 フォルダー内の GroupSample.fsp プロジェクトを開きます。ツリーは次の図に示されています。
図からわかるように、FormID 要素が検出されると、InvoiceNumHeader 要素に対して複数の仮説が生成されるため、仮説ツリーは分岐します。その結果、FlexiLayout Studio は各チェーンの品質を比較するために、その都度、先頭の要素から末尾の要素までたどる必要があります。
さらに、この例より複雑なレイアウトのドキュメントでは、グループ要素のない FlexiLayout は分岐が多すぎる仮説ツリーを生成するため、FlexiLayout のマッチングはいっそう難しくなります。
探している要素をすべて 1 つのルートグループに配置することは避けてください。これは、要素数が 10 未満の非常に単純な FlexiLayout にのみ適していますが、実際のタスクでそのようなケースはごくまれです。ルート グループ 内の要素数が増えると、仮説の数は急激に増加し、10,000 という上限に達するか、仮説ツリーに割り当てられたメモリを使い切るまで増え続けます。どちらの場合でも、FlexiLayout のマッチングに失敗する可能性があります。
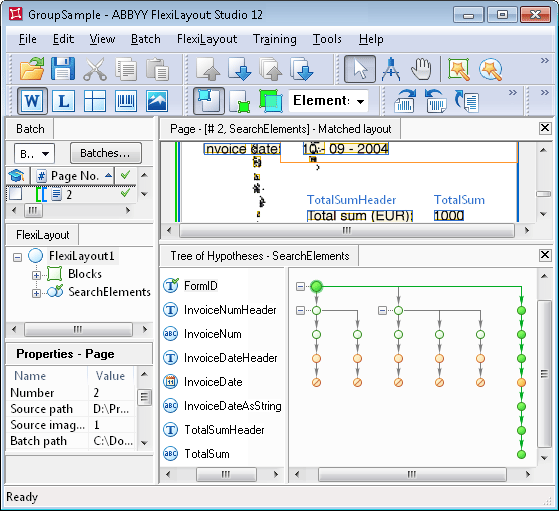
グループ化されていない仮説ツリーは分岐が多すぎるため、見た目で解析するのが困難です。